視覺語言基礎模型 · 知識圖譜推理 · 眼科影像解讀
EyeGraph:以知識圖譜推理支持眼科影像解讀的多粒度醫學視覺語言基礎模型
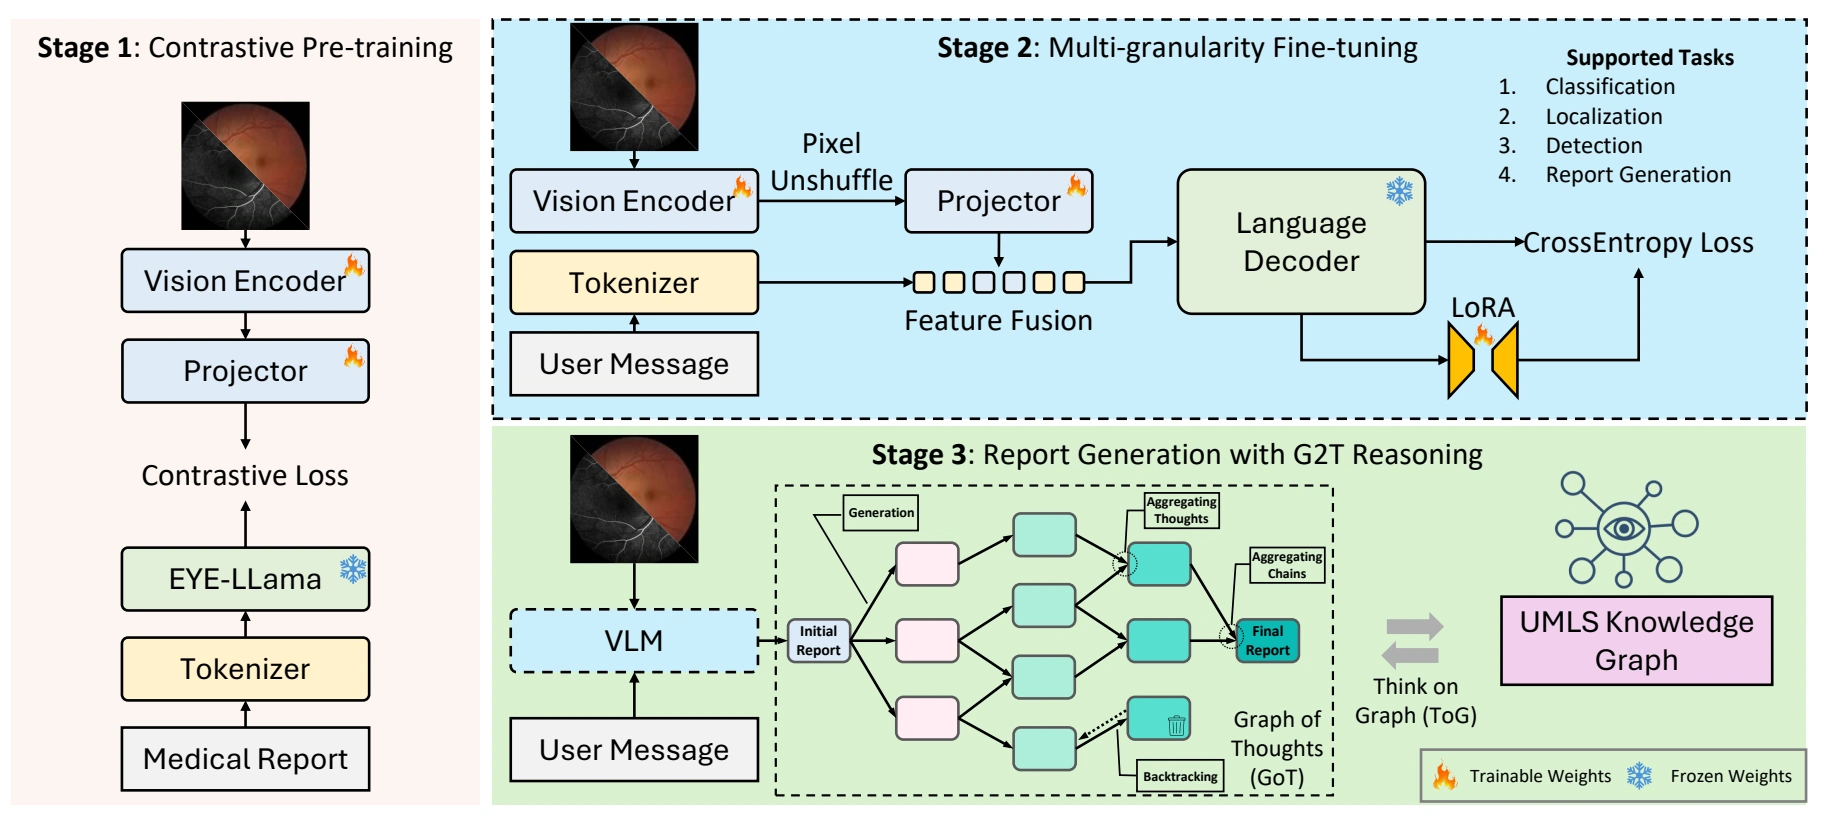
EyeGraph 利用 IT-Retinal 指令數據,將影像級診斷、解剖結構定位與報告生成納入同一視覺語言模型。報告生成時,G2T 從 UMLS 知識圖譜檢索相關關係,為推理提供依據,提升報告的事實一致性。
按年份收錄期刊論文、會議論文和預印本。期刊影響因子和會議評級均鏈接至數據來源。
69 條記錄
視覺語言基礎模型 · 知識圖譜推理 · 眼科影像解讀
EyeGraph 利用 IT-Retinal 指令數據,將影像級診斷、解剖結構定位與報告生成納入同一視覺語言模型。報告生成時,G2T 從 UMLS 知識圖譜檢索相關關係,為推理提供依據,提升報告的事實一致性。
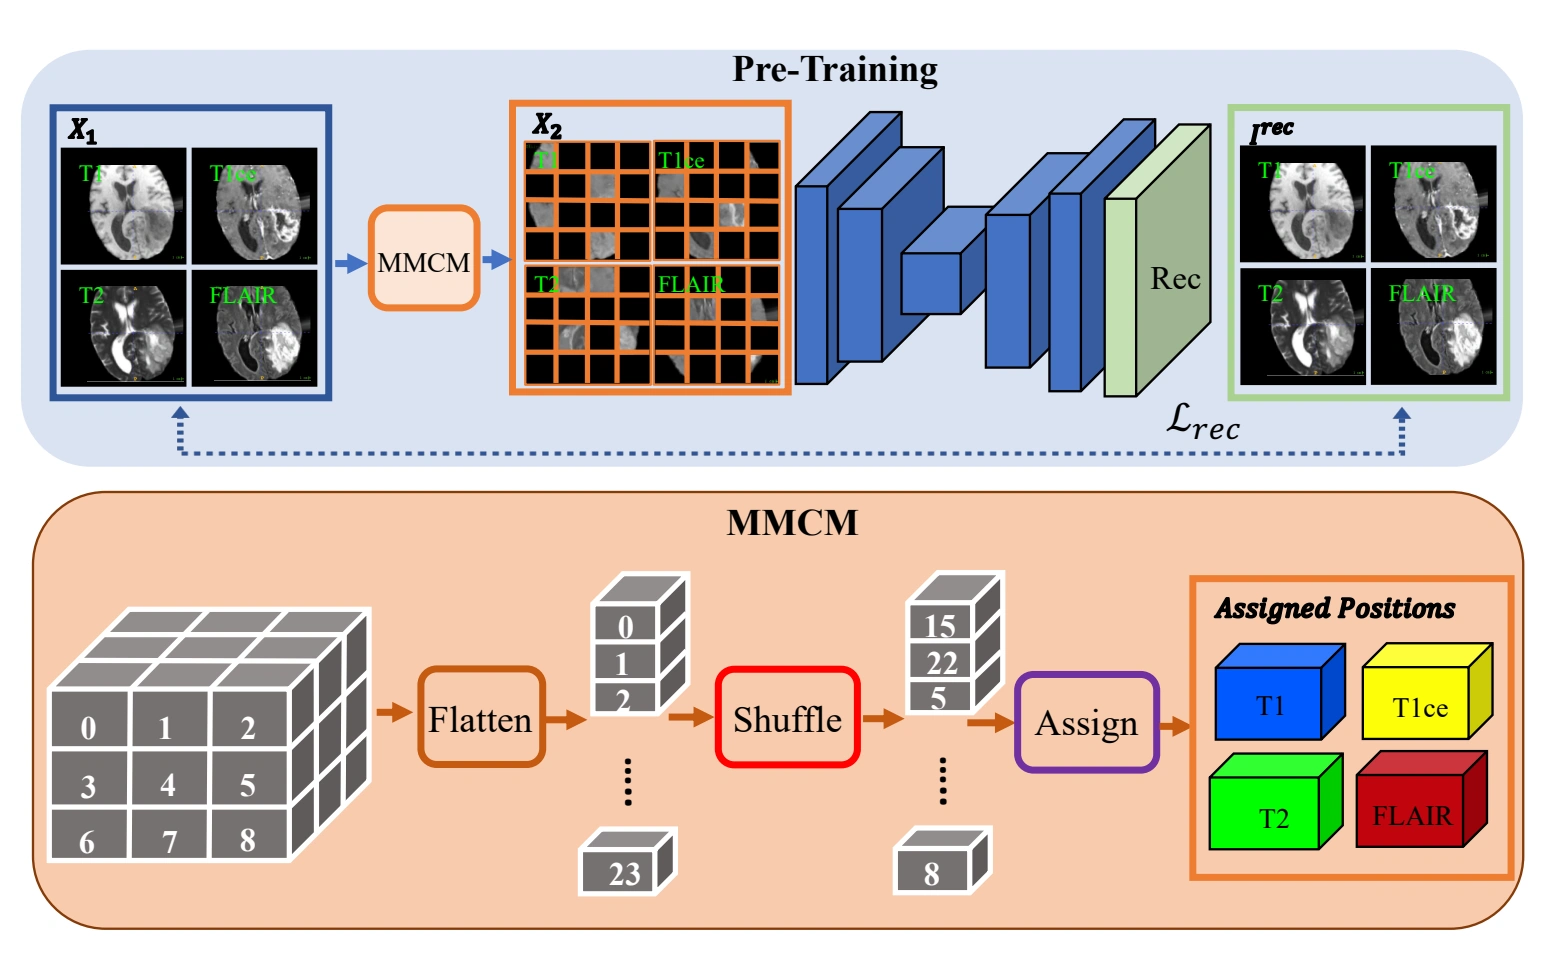
自監督預訓練 · 掩碼互補建模 · 多模態磁共振分割
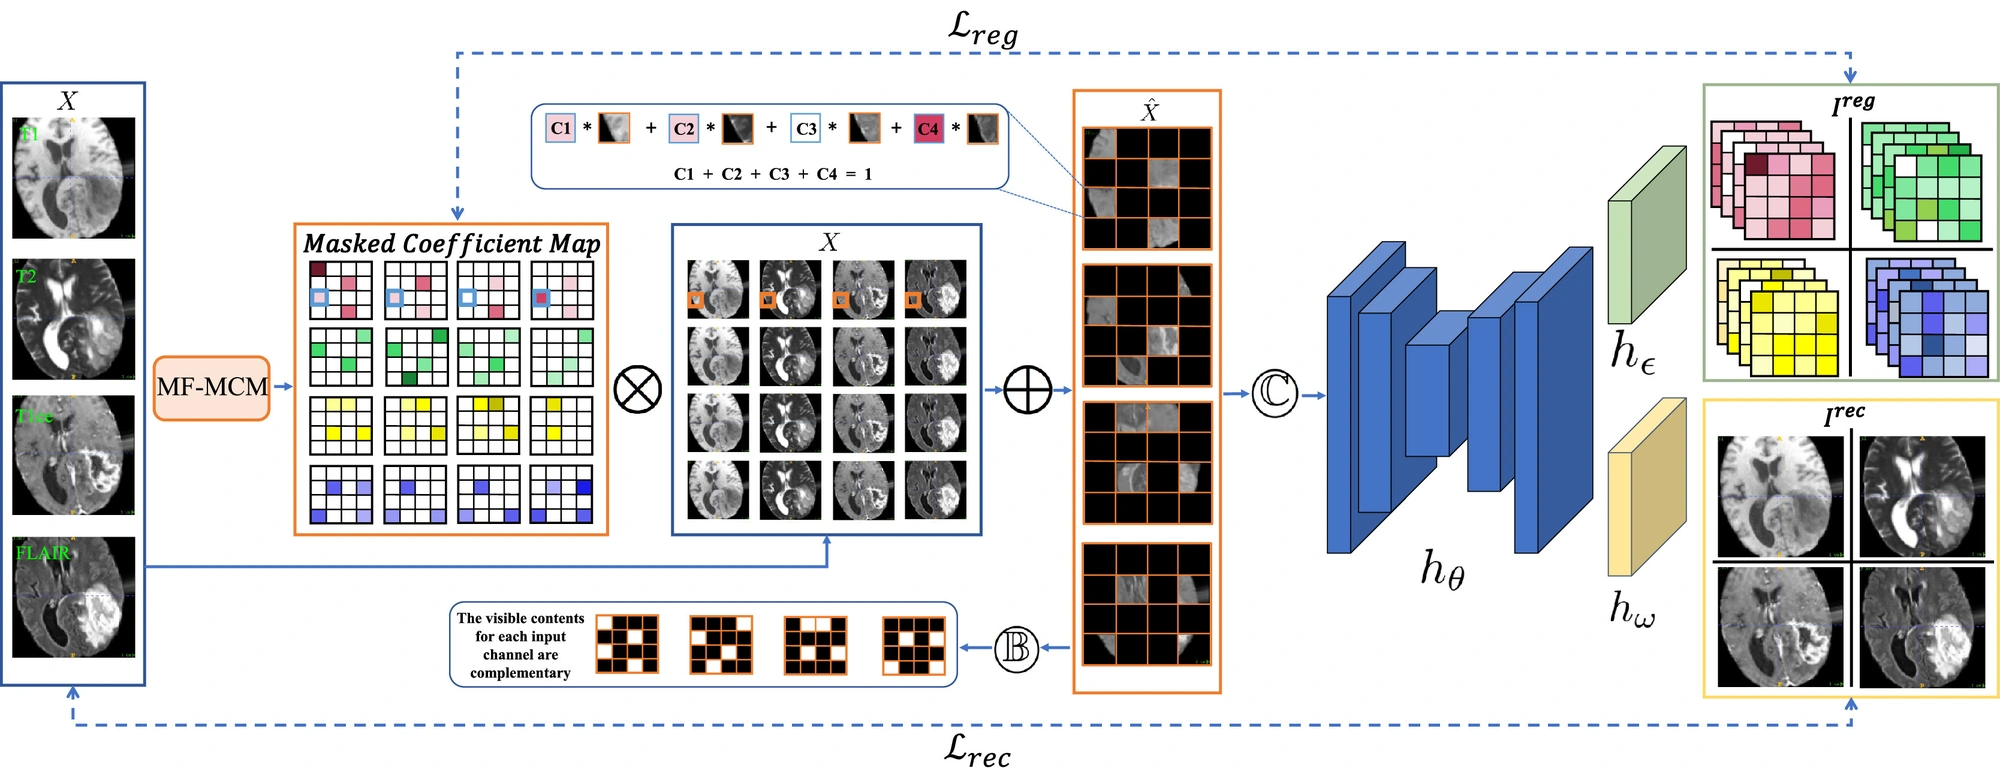
MF-MCM 先融合多序列腦 MRI,再在融合通道間分配互補掩碼,以原始序列重建與融合係數迴歸為聯合預訓練目標。研究在五個數據集上評估分割遷移,並考察少標註與序列缺失時的表現。
層級提示 · 雙向一致性學習 · 多粒度分割
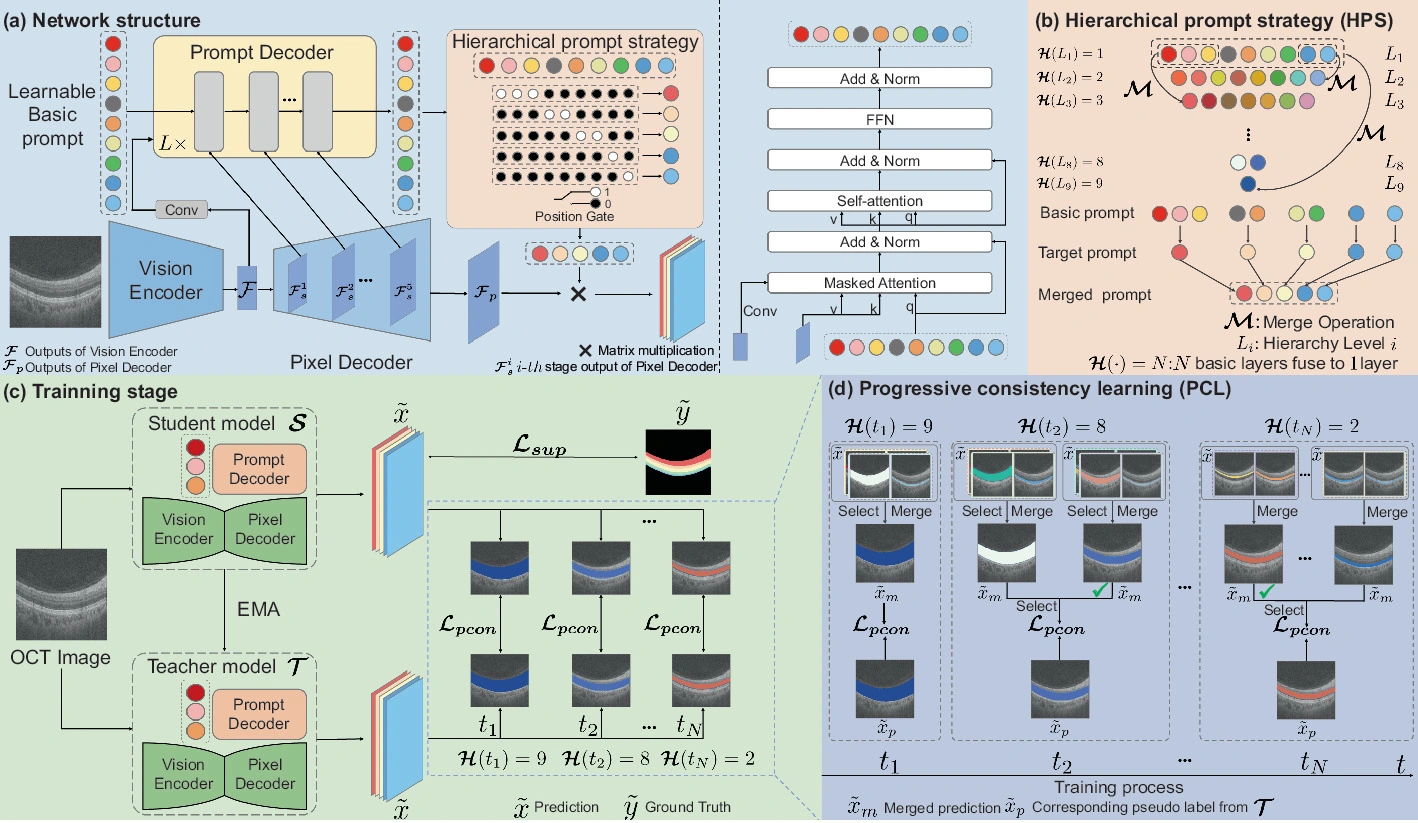
UniOCTSeg++ 面向不同數據集的視網膜層標註協議,用成對的前景與背景提示顯式表示解剖層級,並在粗、細粒度預測之間施加雙向一致性約束。在論文構建的 HROCT-Bench 上,聯合利用無標註掃描時,僅使用 30% 的有標註數據即可接近全監督基線。
視覺基礎模型 · 三維光學相干斷層成像 · 患者級診斷流程
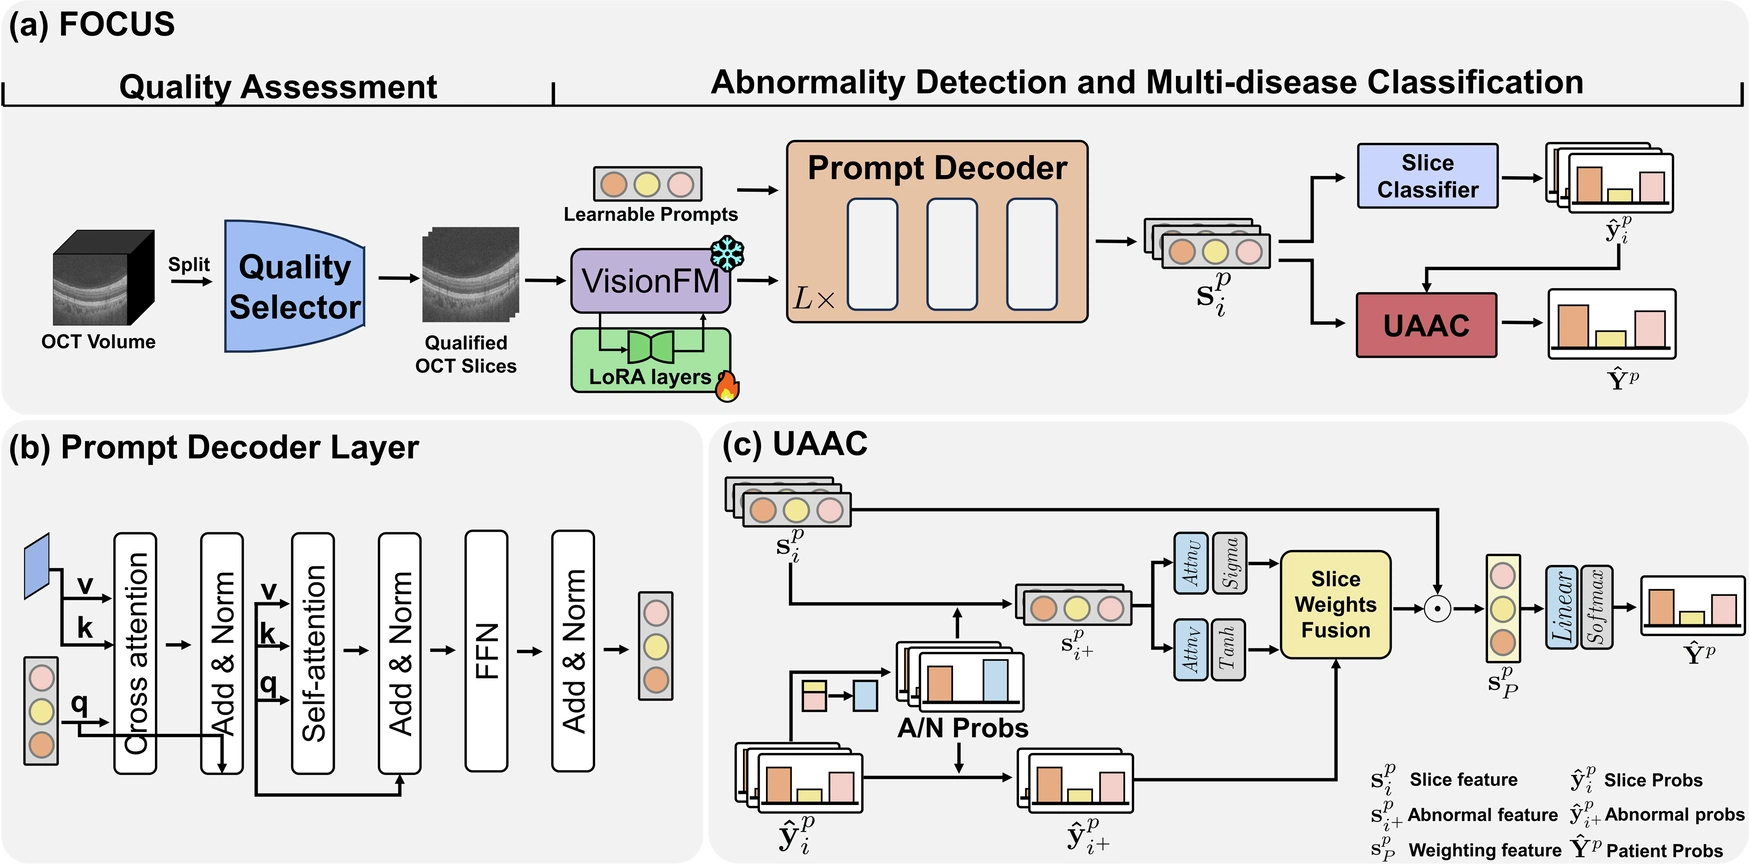
FOCUS 將切片質控、基於 VisionFM 的異常檢測與多病種分類納入三維 OCT 診斷流程,再基於注意力聚合異常切片的特徵,得到患者級診斷。四家外部中心共納入 1,345 名患者,合併計算的患者級 F1 為 94.05%。
多智能體協作推理 · 多模態臨牀數據 · 基於臨牀指南的評估
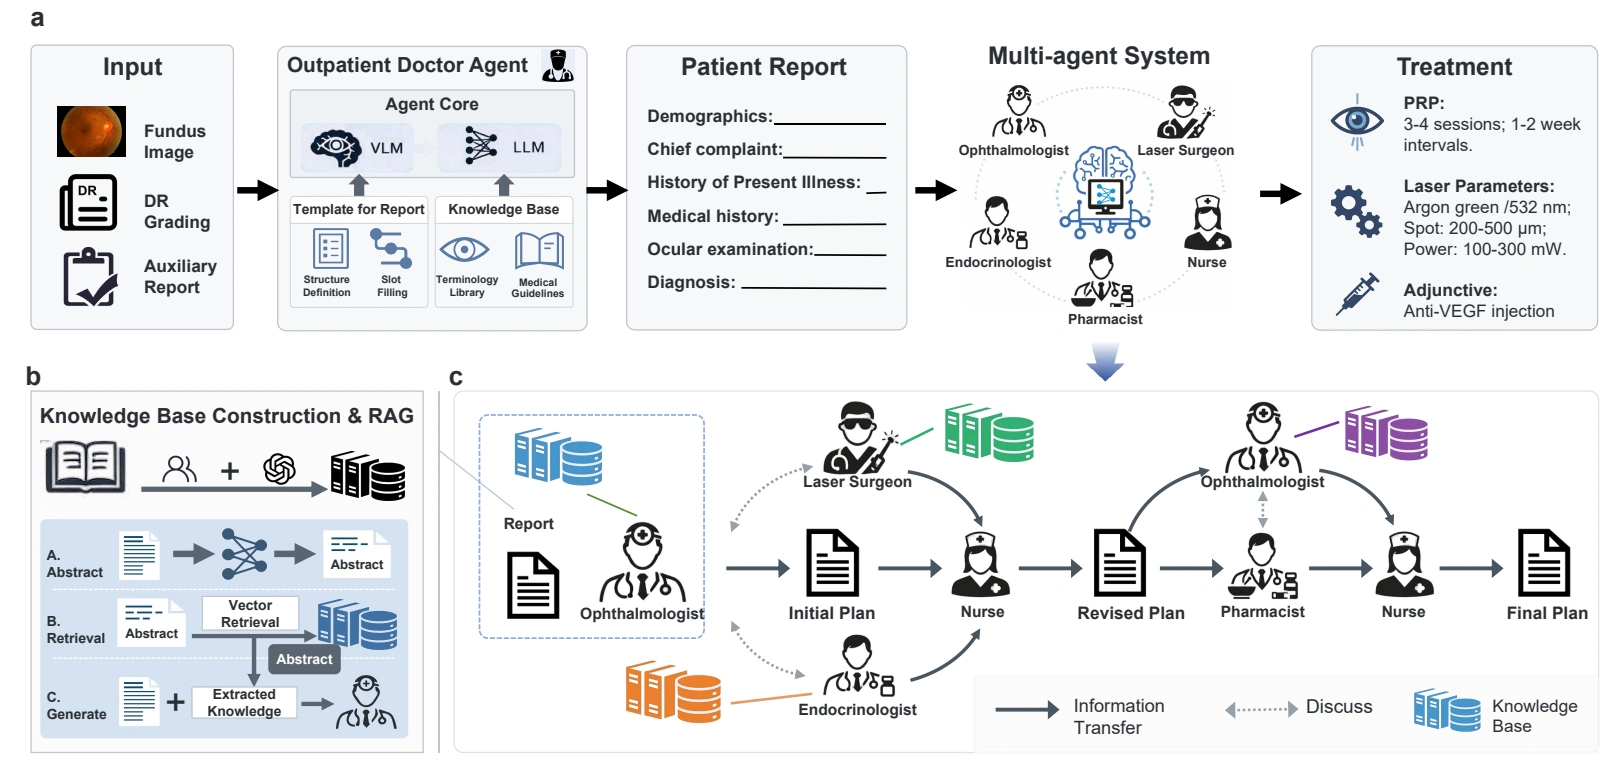
DRAgent 將糖尿病視網膜病變的治療規劃建模為基於影像與病歷的多專科智能體協作。預印本構建了關聯眼底照、病歷和治療方案的數據集,並用指南符合性、醫生評價及專科智能體消融檢驗方案質量。
期相條件擴散 · 上下文感知融合 · 多期相 CT 分割
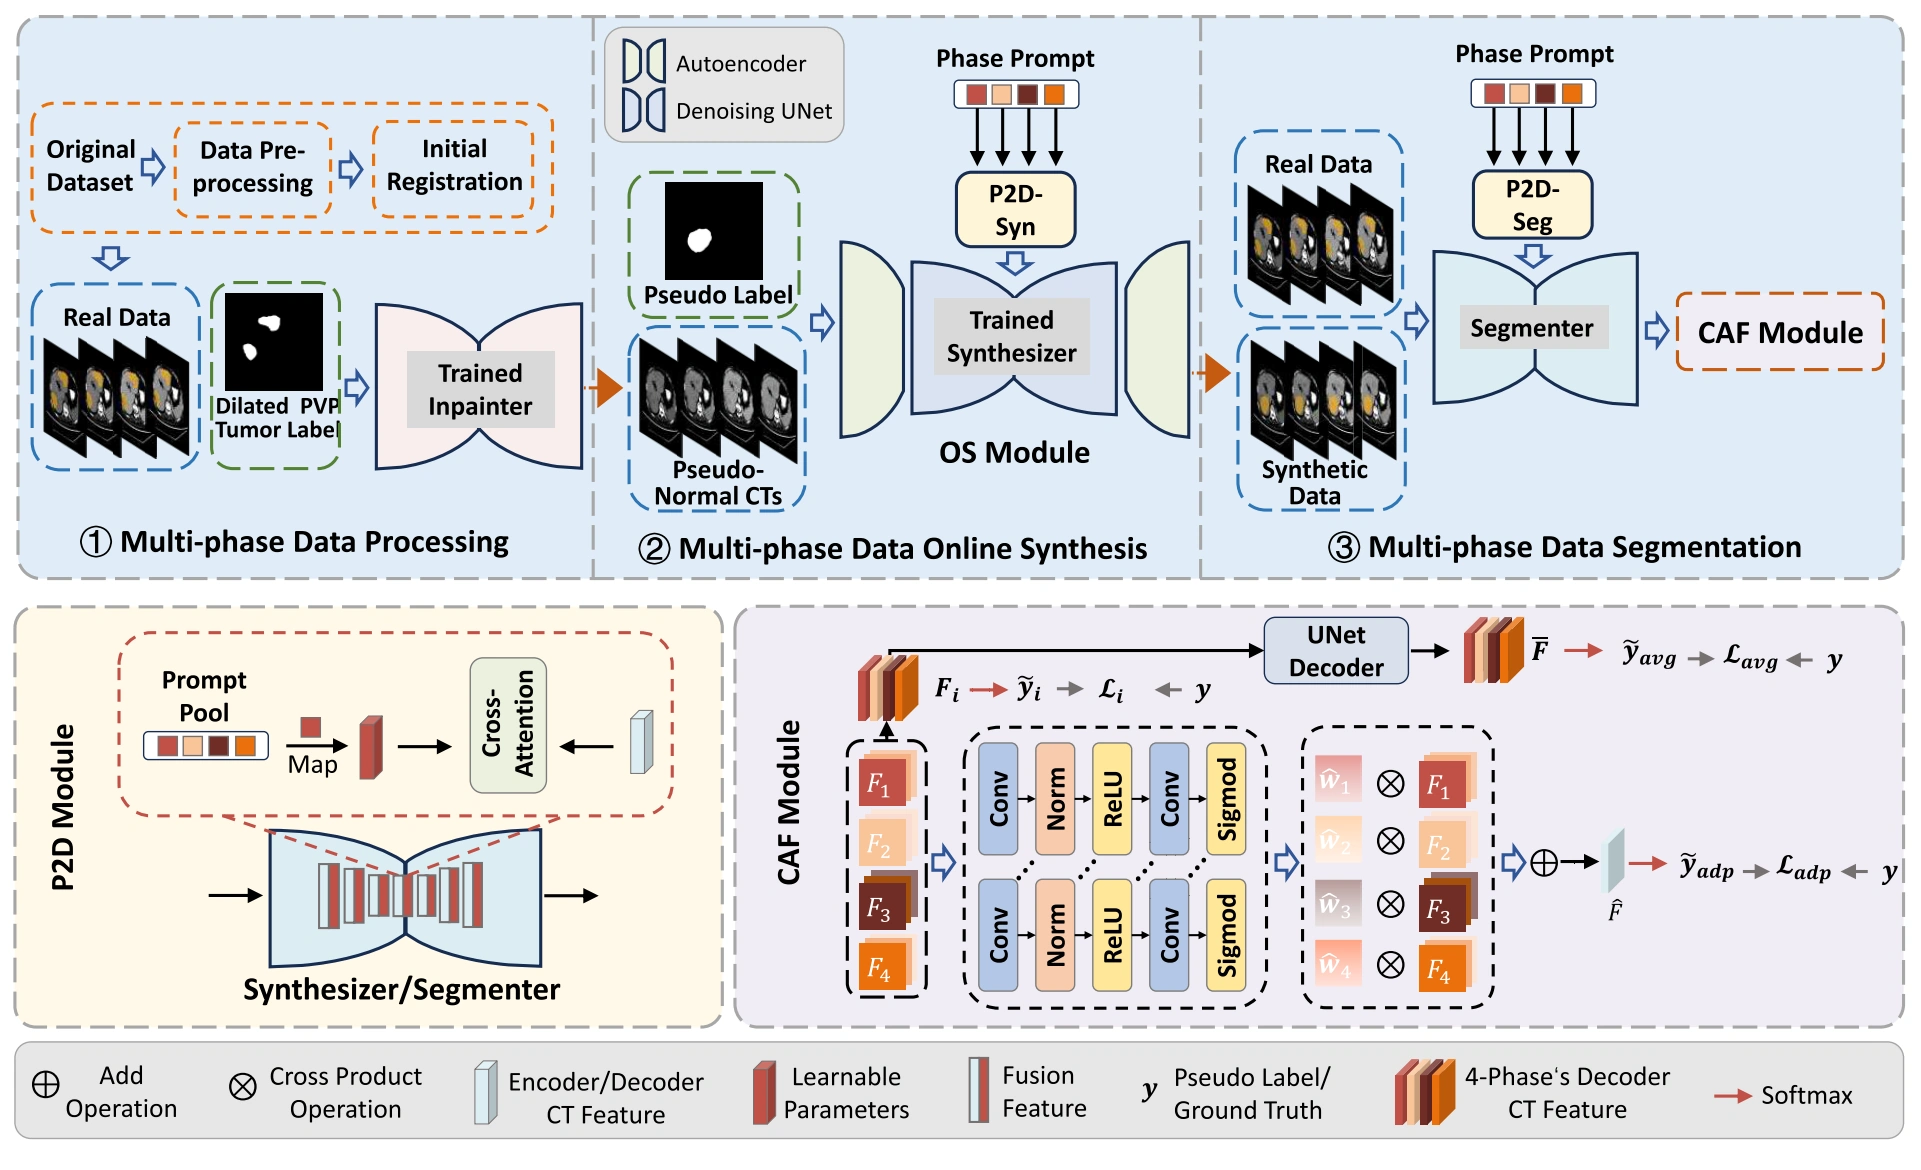
SynLiTS 以 CT 期相為條件進行擴散生成,在各期相對齊的位置合成肝腫瘤。上下文感知融合使分割模型能夠聯合利用空間對齊的合成數據和存在配準誤差的真實影像。研究同時構建了真實多期相肝腫瘤數據集 MPLiTS。
長尾識別 · 尾類樣本合成 · 類別均衡對比學習
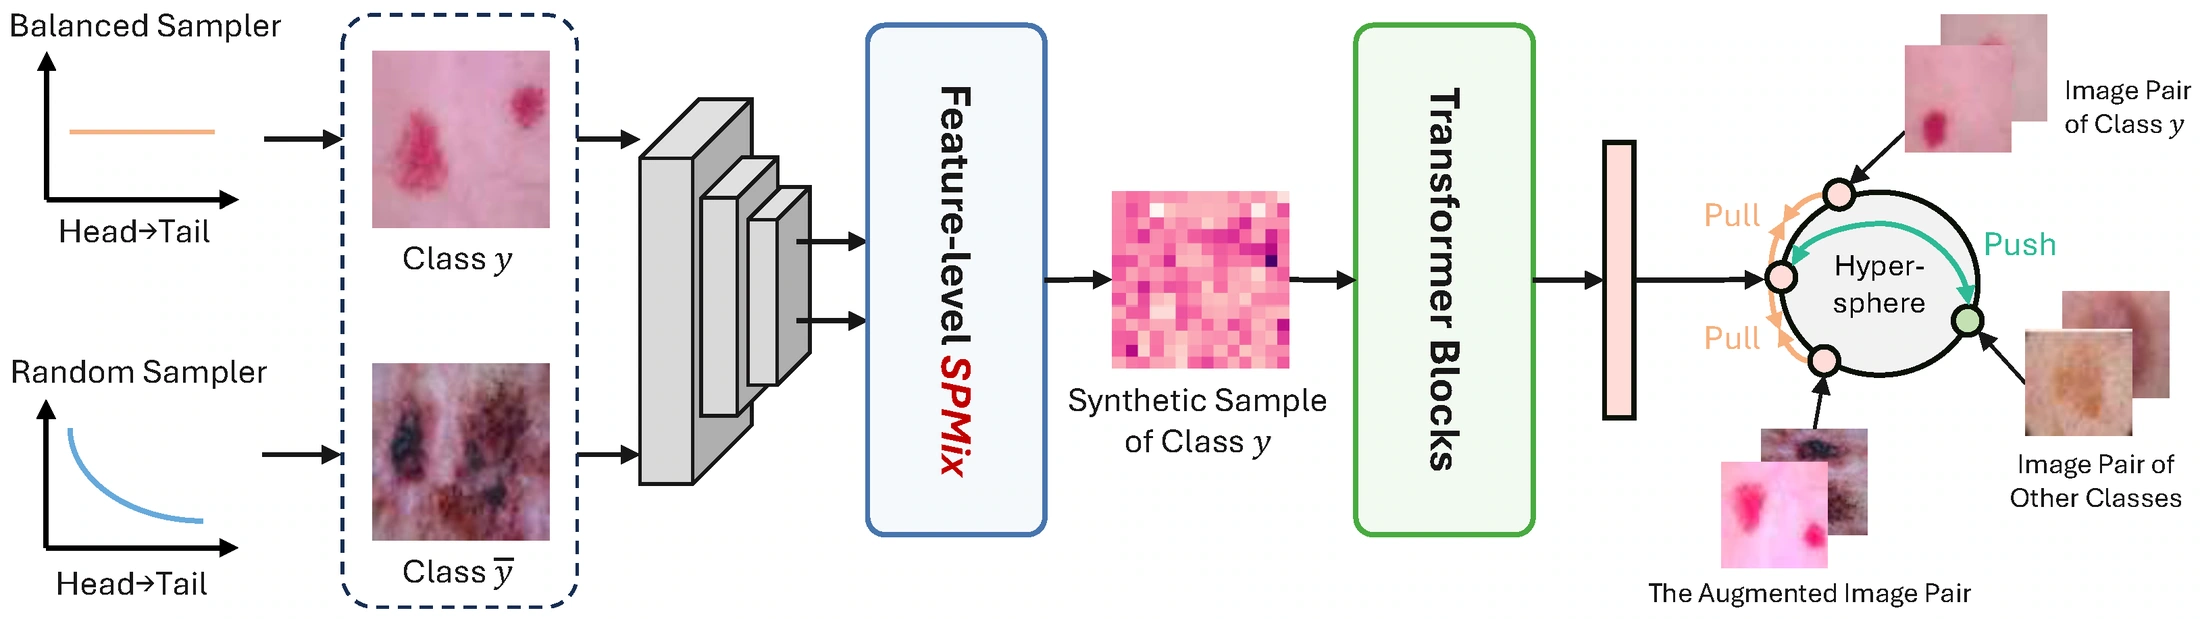
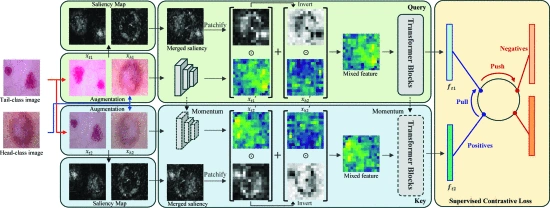
TailBoost 將少數類樣本合成與均衡表徵學習結合,用顯著性引導的局部混合保留少數類病灶特徵,再以類別中心重平衡修正監督對比目標。研究在三個皮損數據集上驗證了該方法對長尾分類的作用。
無標註學習 · 傅里葉域合成 · 腦血管分割
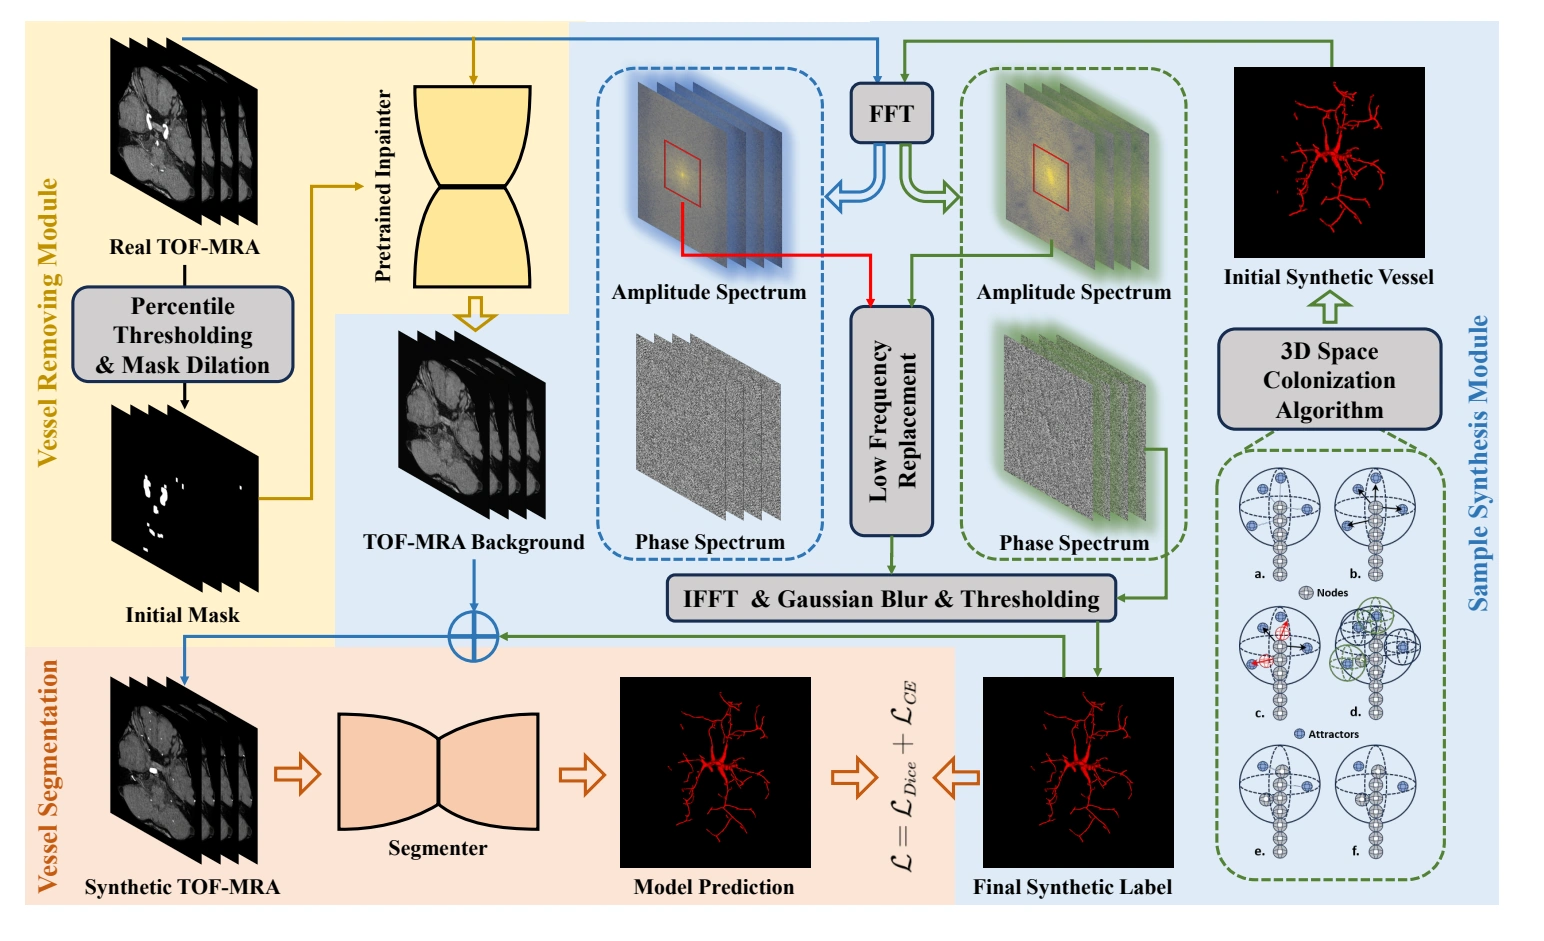
該方法以空間殖民算法生成三維血管樹,再通過頻域融合將合成血管嵌入去除血管信號的 TOF-MRA 背景。合成圖像及其掩碼為腦血管分割提供稠密監督,無需人工描繪血管,訓練後在真實掃描上進行評估。
解剖先驗 · 擴散 CT 合成 · PET 衰減校正
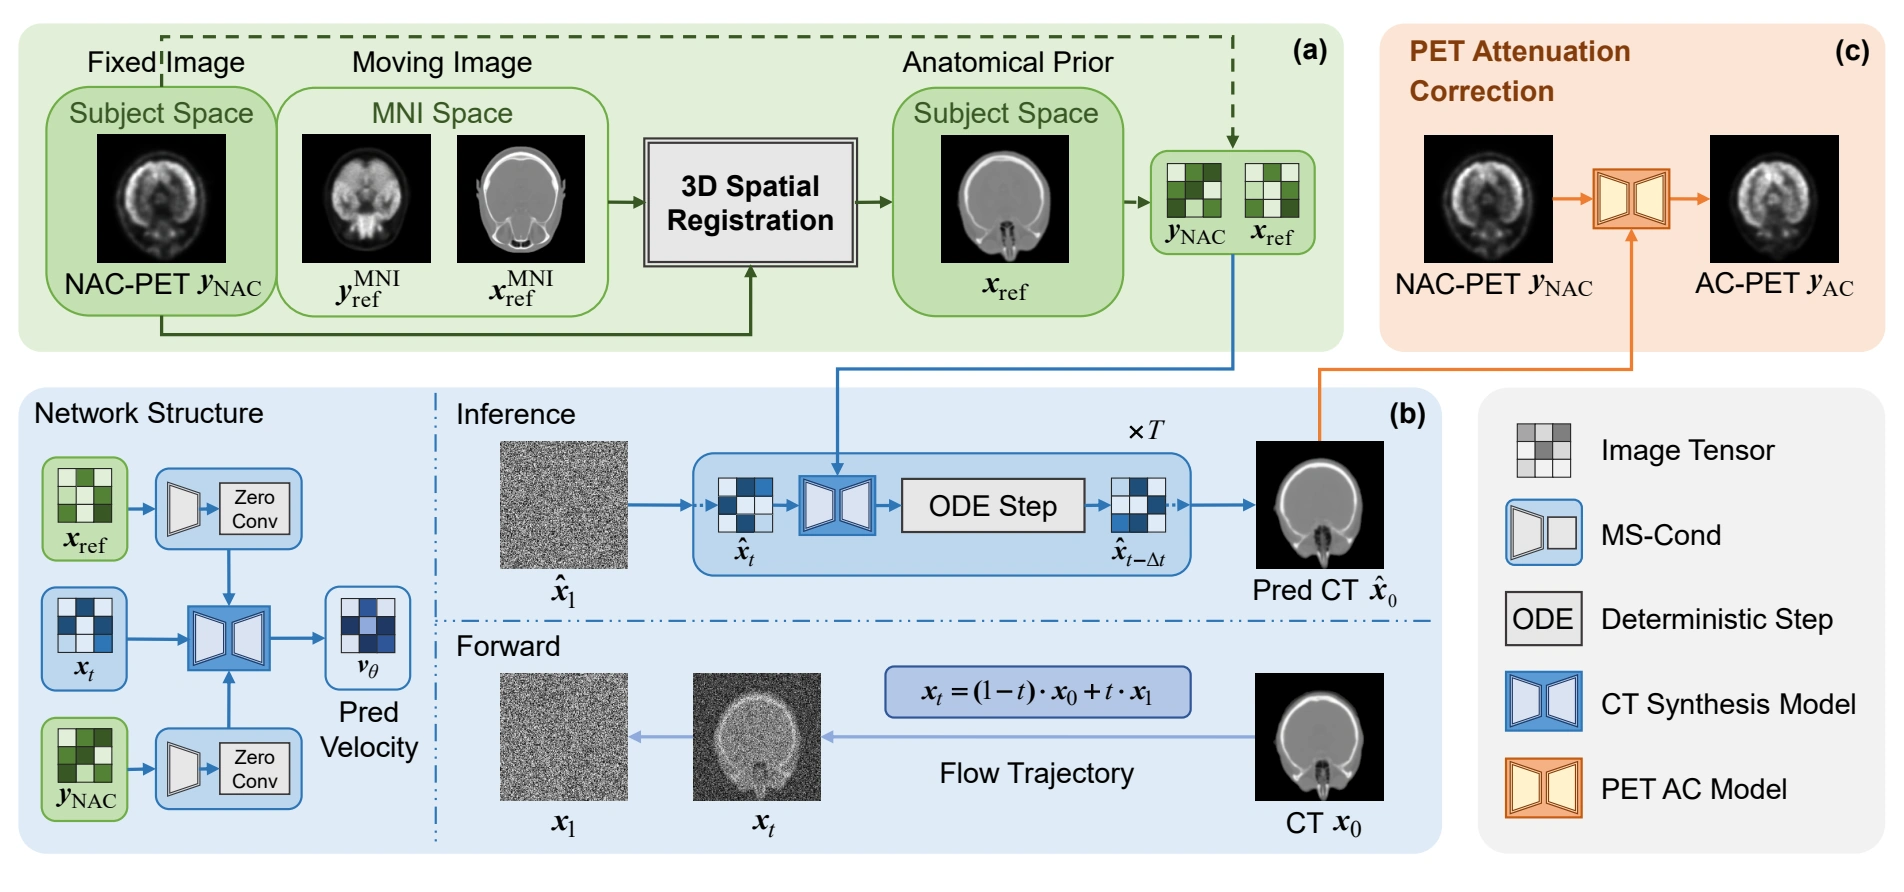
DAPS 將腦部模板形變配準至未經校正的個體 PET,以所得解剖先驗引導擴散模型合成 CT。校正網絡再融合合成 CT 與原始 PET,估計衰減校正後的圖像。研究在兩個公開 PET/CT 數據集上評估該流程。
半監督學習 · 可靠性感知互學習 · 多粒度 OCT 分割
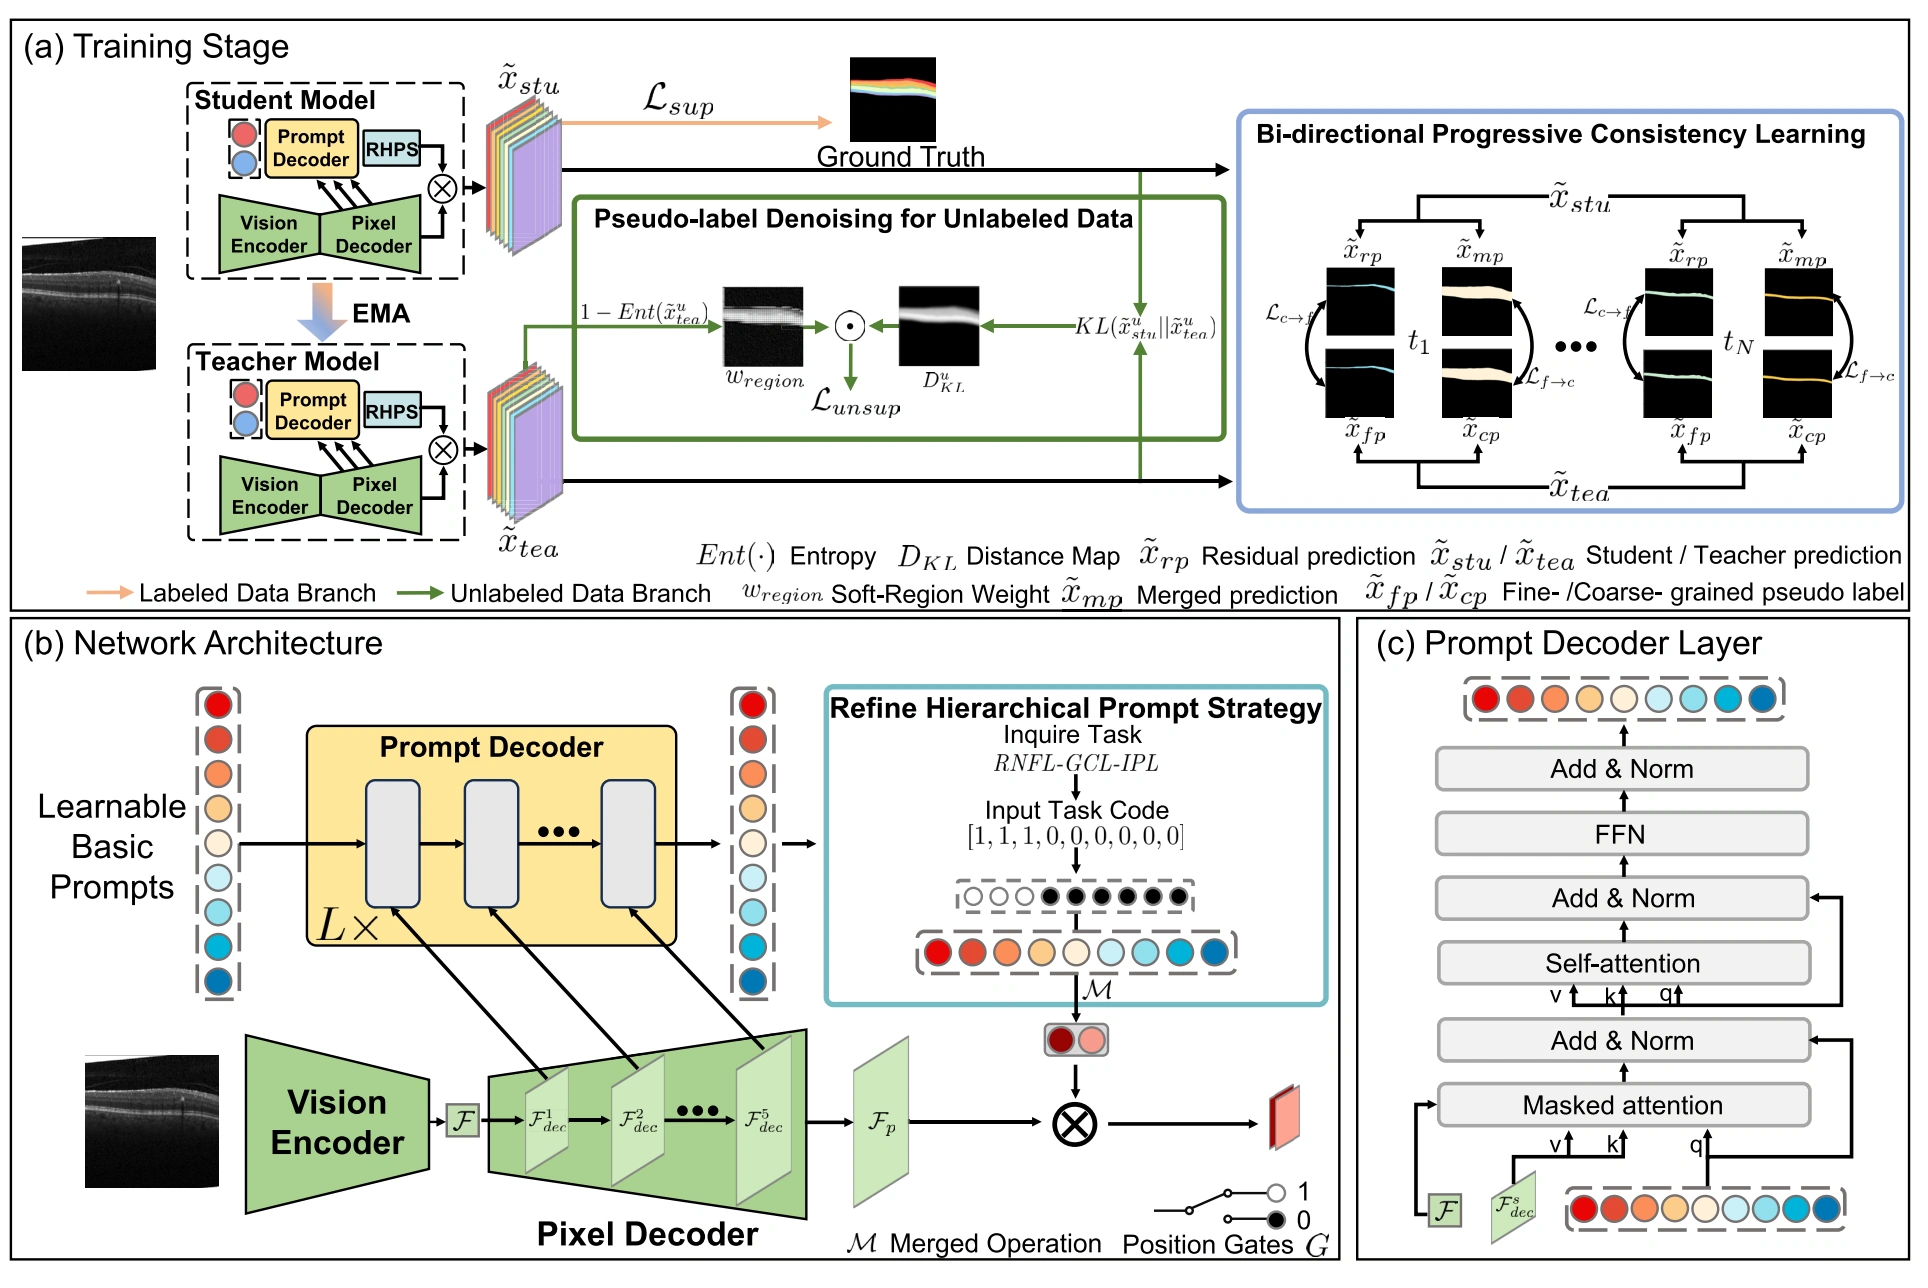
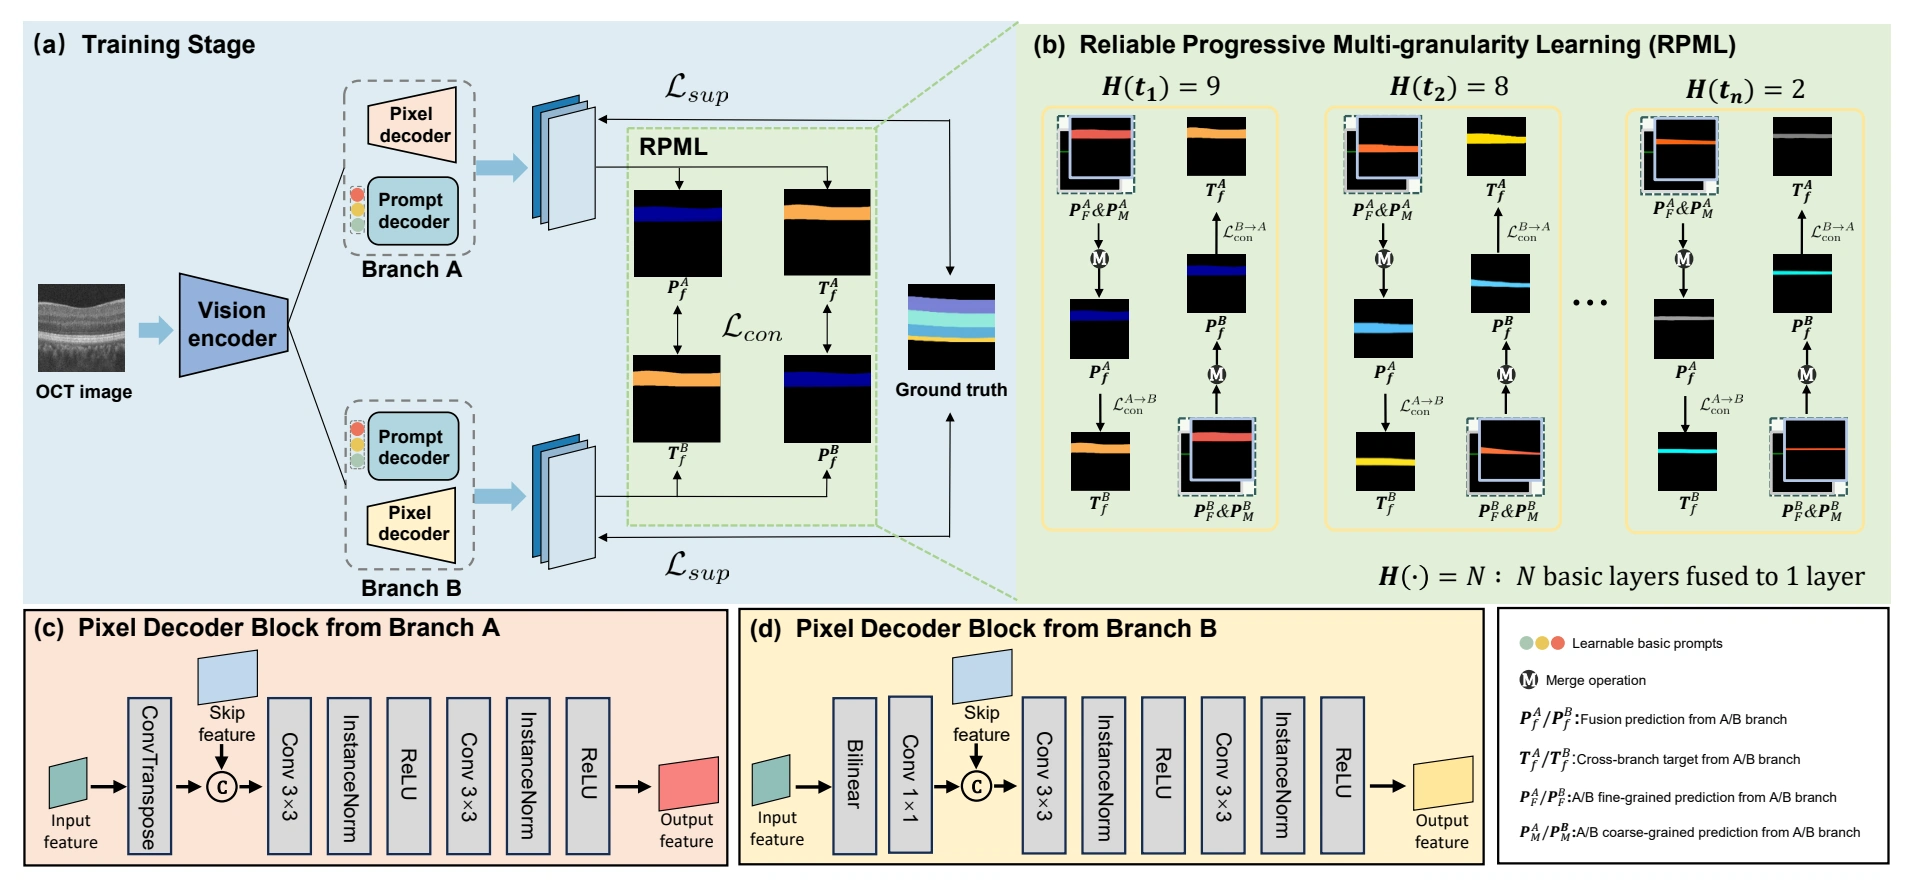
LUMOS 面向標註有限且解剖粒度各異的 OCT 數據,結合無標註掃描與多粒度標註訓練。層級提示調節雙解碼器,通過區域級可靠性加權在不同標註粒度之間交換偽標籤。實驗覆蓋六個 OCT 數據集。
跨物種三維重建 · 類羣感知建模 · 擴散數據合成
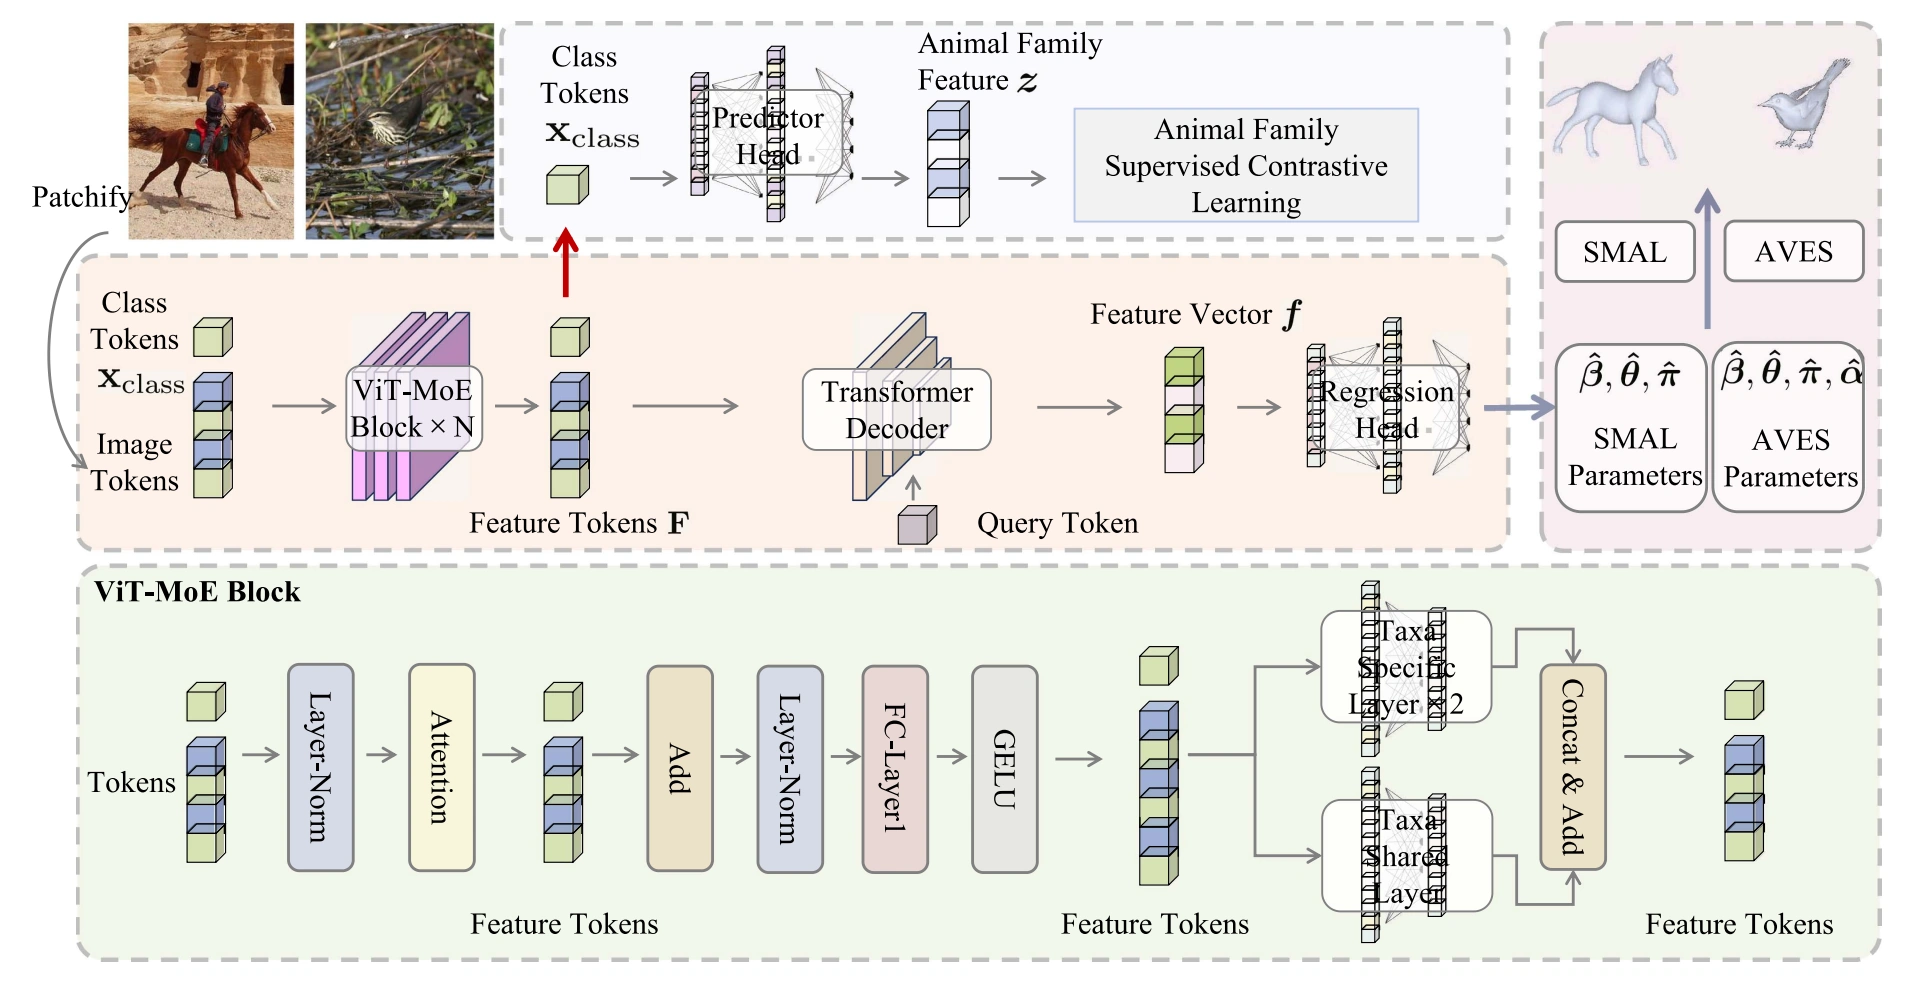
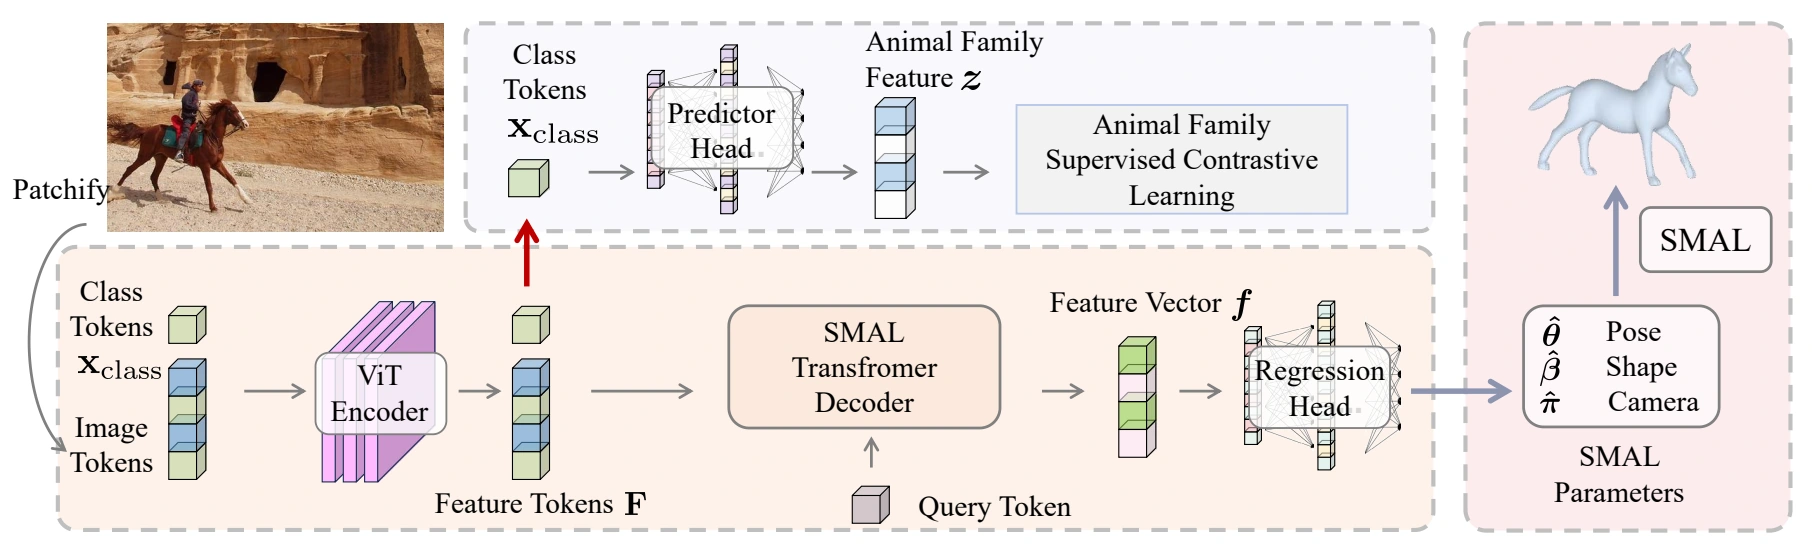
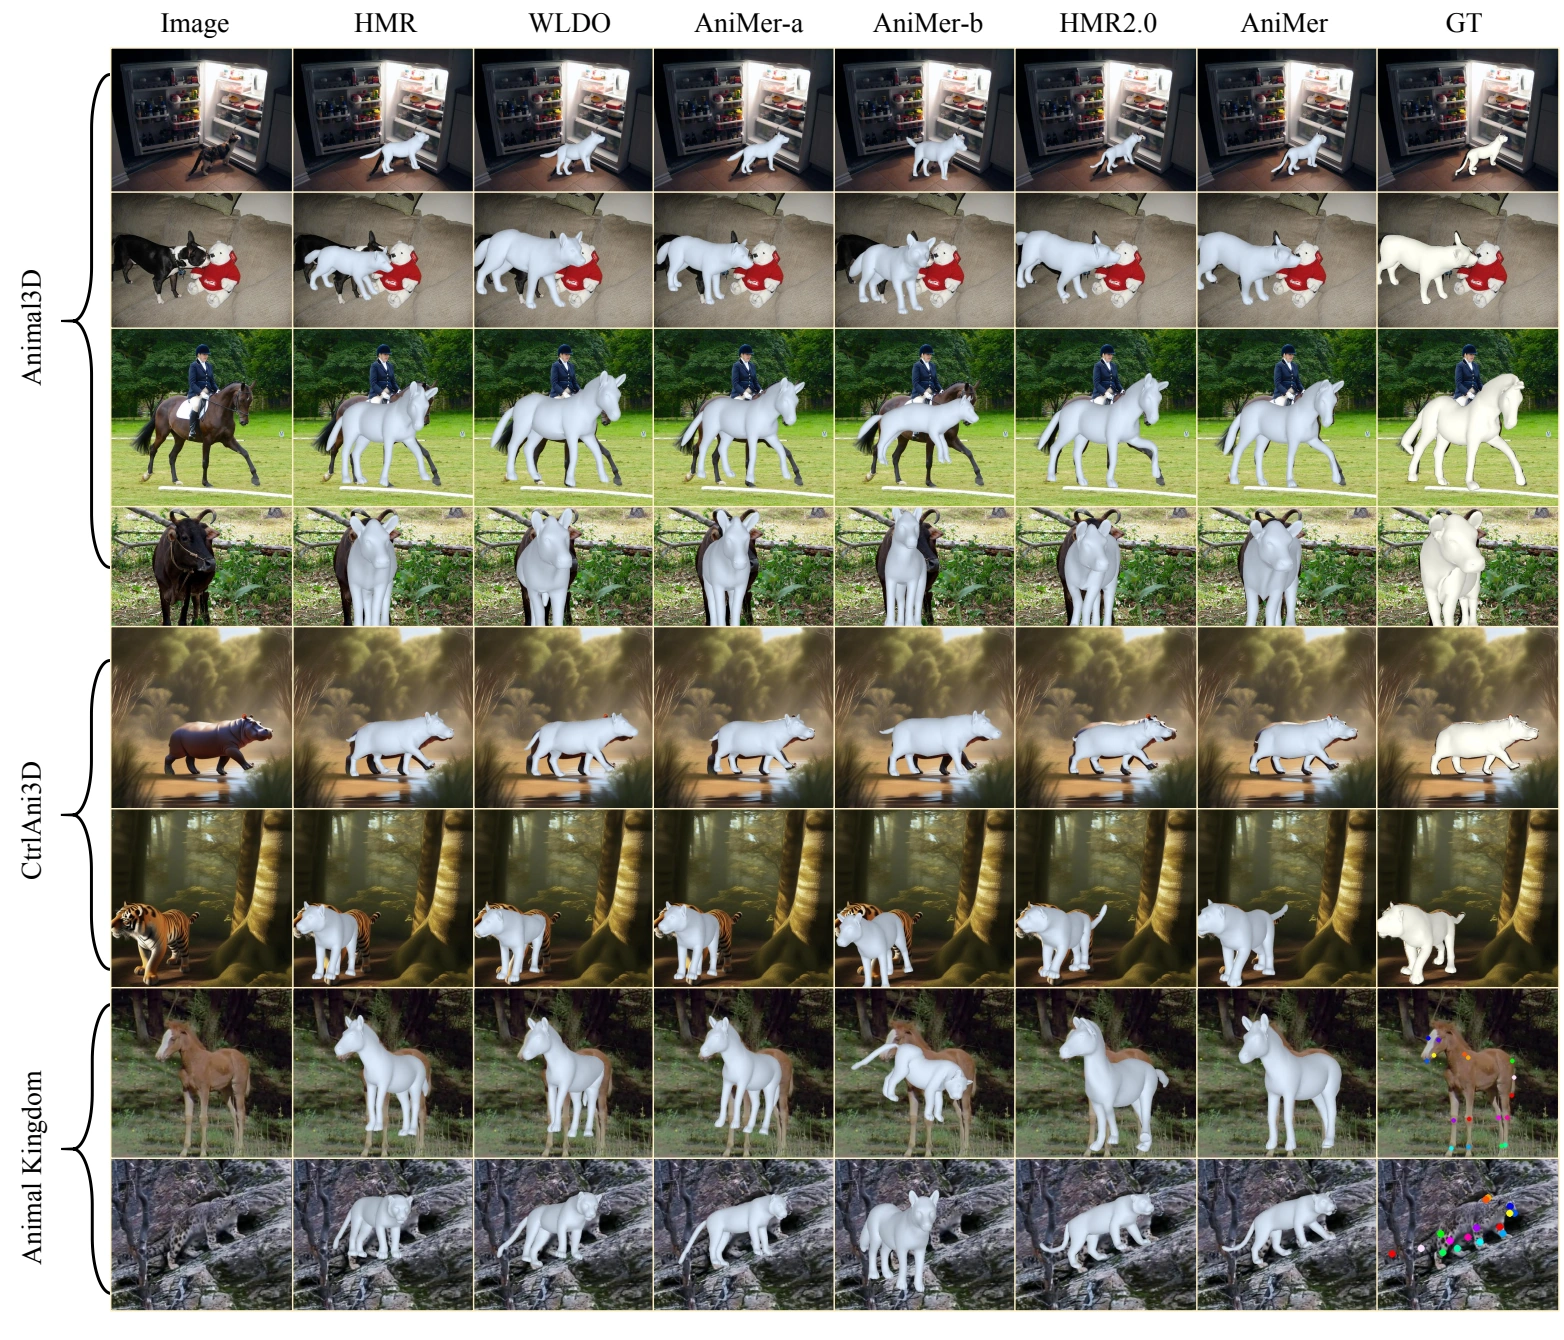
AniMer+ 結合共享 Transformer 層與類羣專屬專家,在統一模型中重建四足哺乳動物和鳥類的三維姿態與形狀。研究以擴散生成補充像素對齊的三維標註,並在分佈外的 Animal Kingdom 基準上評估遷移表現。
醫學圖文預訓練 · 最優傳輸 · 魯棒對比學習
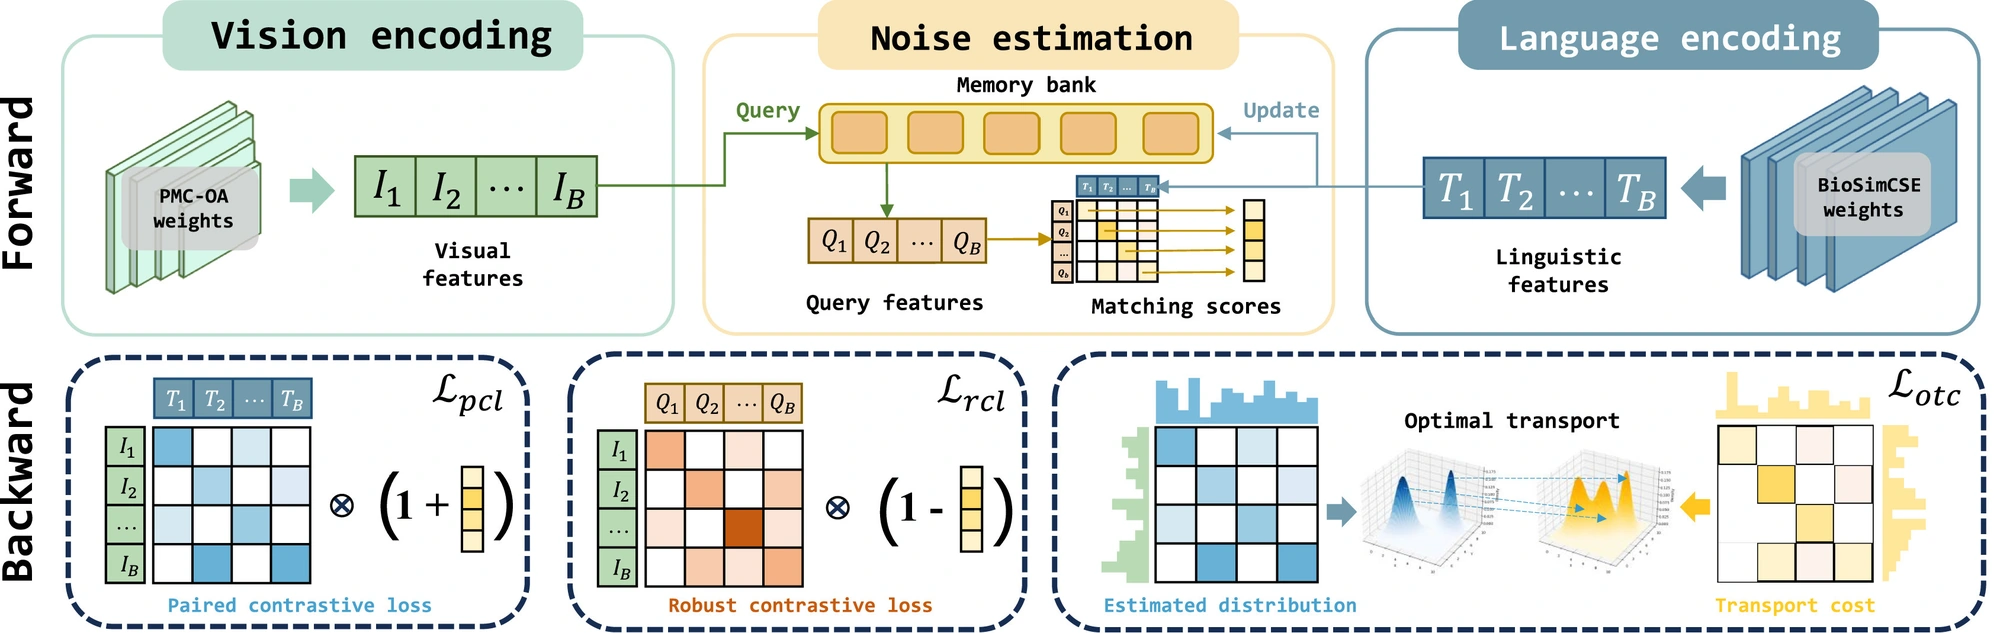
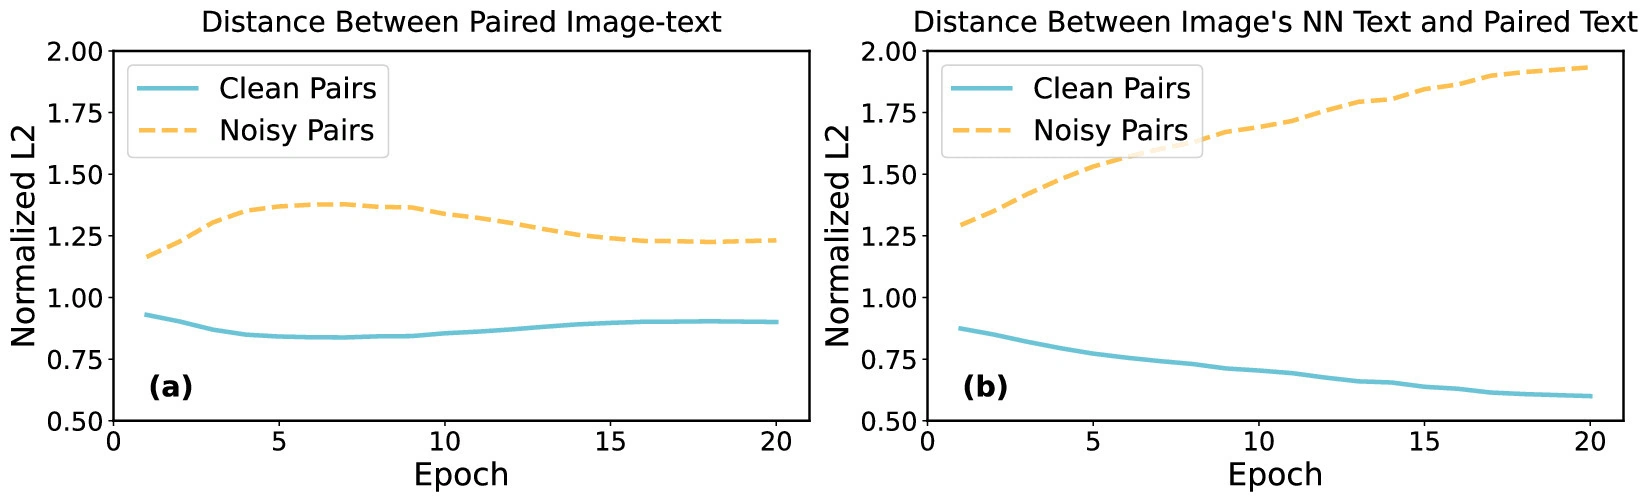
MIRAGE 針對醫學圖文對比預訓練中的錯誤配對和假負例,以跨模態近鄰為先驗,用最優傳輸估計樣本之間的匹配關係,再通過自適應梯度平衡減輕噪聲監督的影響。研究在 14 個數據集、六項任務上評估了表徵遷移。
掩碼條件潛空間擴散 · 跨期相配準 · 肝腫瘤分割
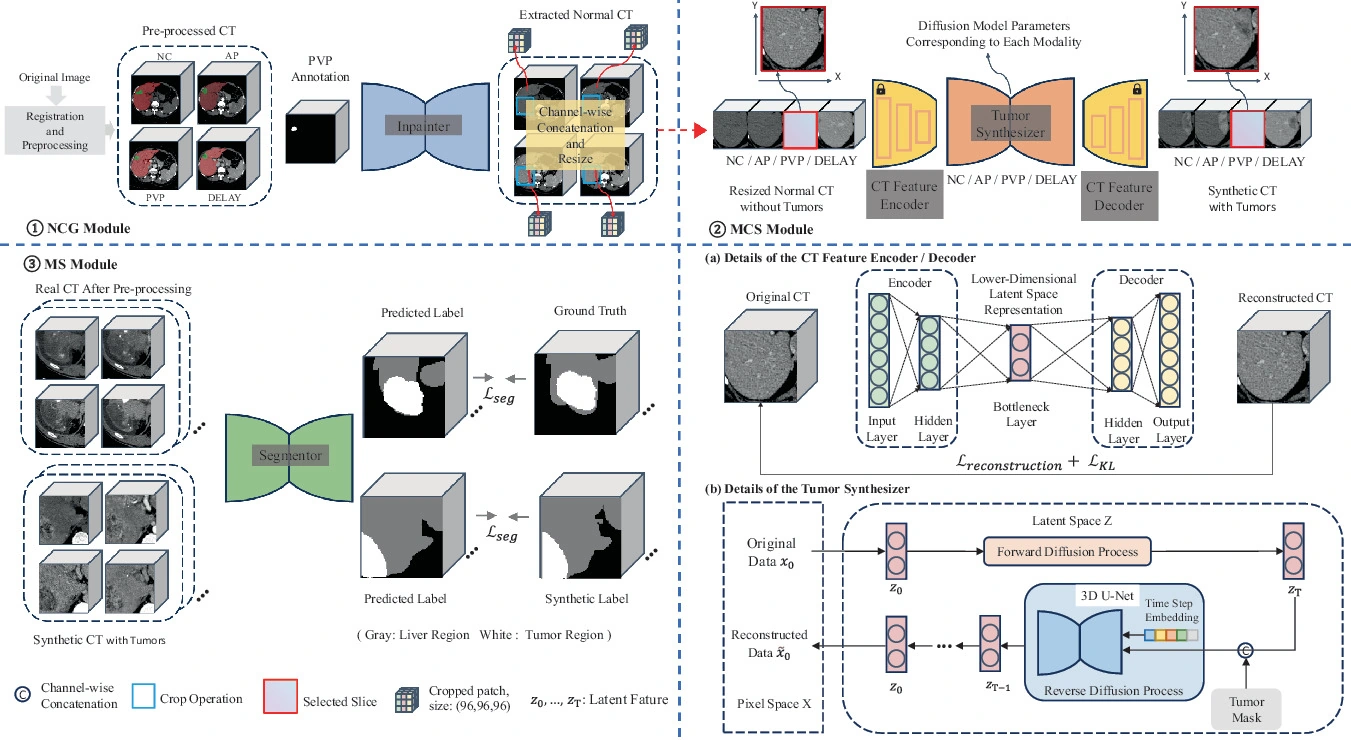
Diff4MMLiTS 為多期相 CT 構造體素級對齊的肝腫瘤監督。該流程先作器官級配準並修復原病灶區域,再以掩碼為條件進行潛空間擴散,在各期相對應位置合成新腫瘤,以訓練分割模型。
層級提示 · 師生一致性 · 多粒度分割
UniOCTSeg 將細粒度視網膜層提示組合成粗粒度提示,在統一的 OCT 分割模型中表示不同標註協議。指數移動平均教師由易到難地在層級間傳遞監督,實驗覆蓋八個數據集、六種標註粒度。
證據學習 · 不確定性估計 · PET/CT 融合
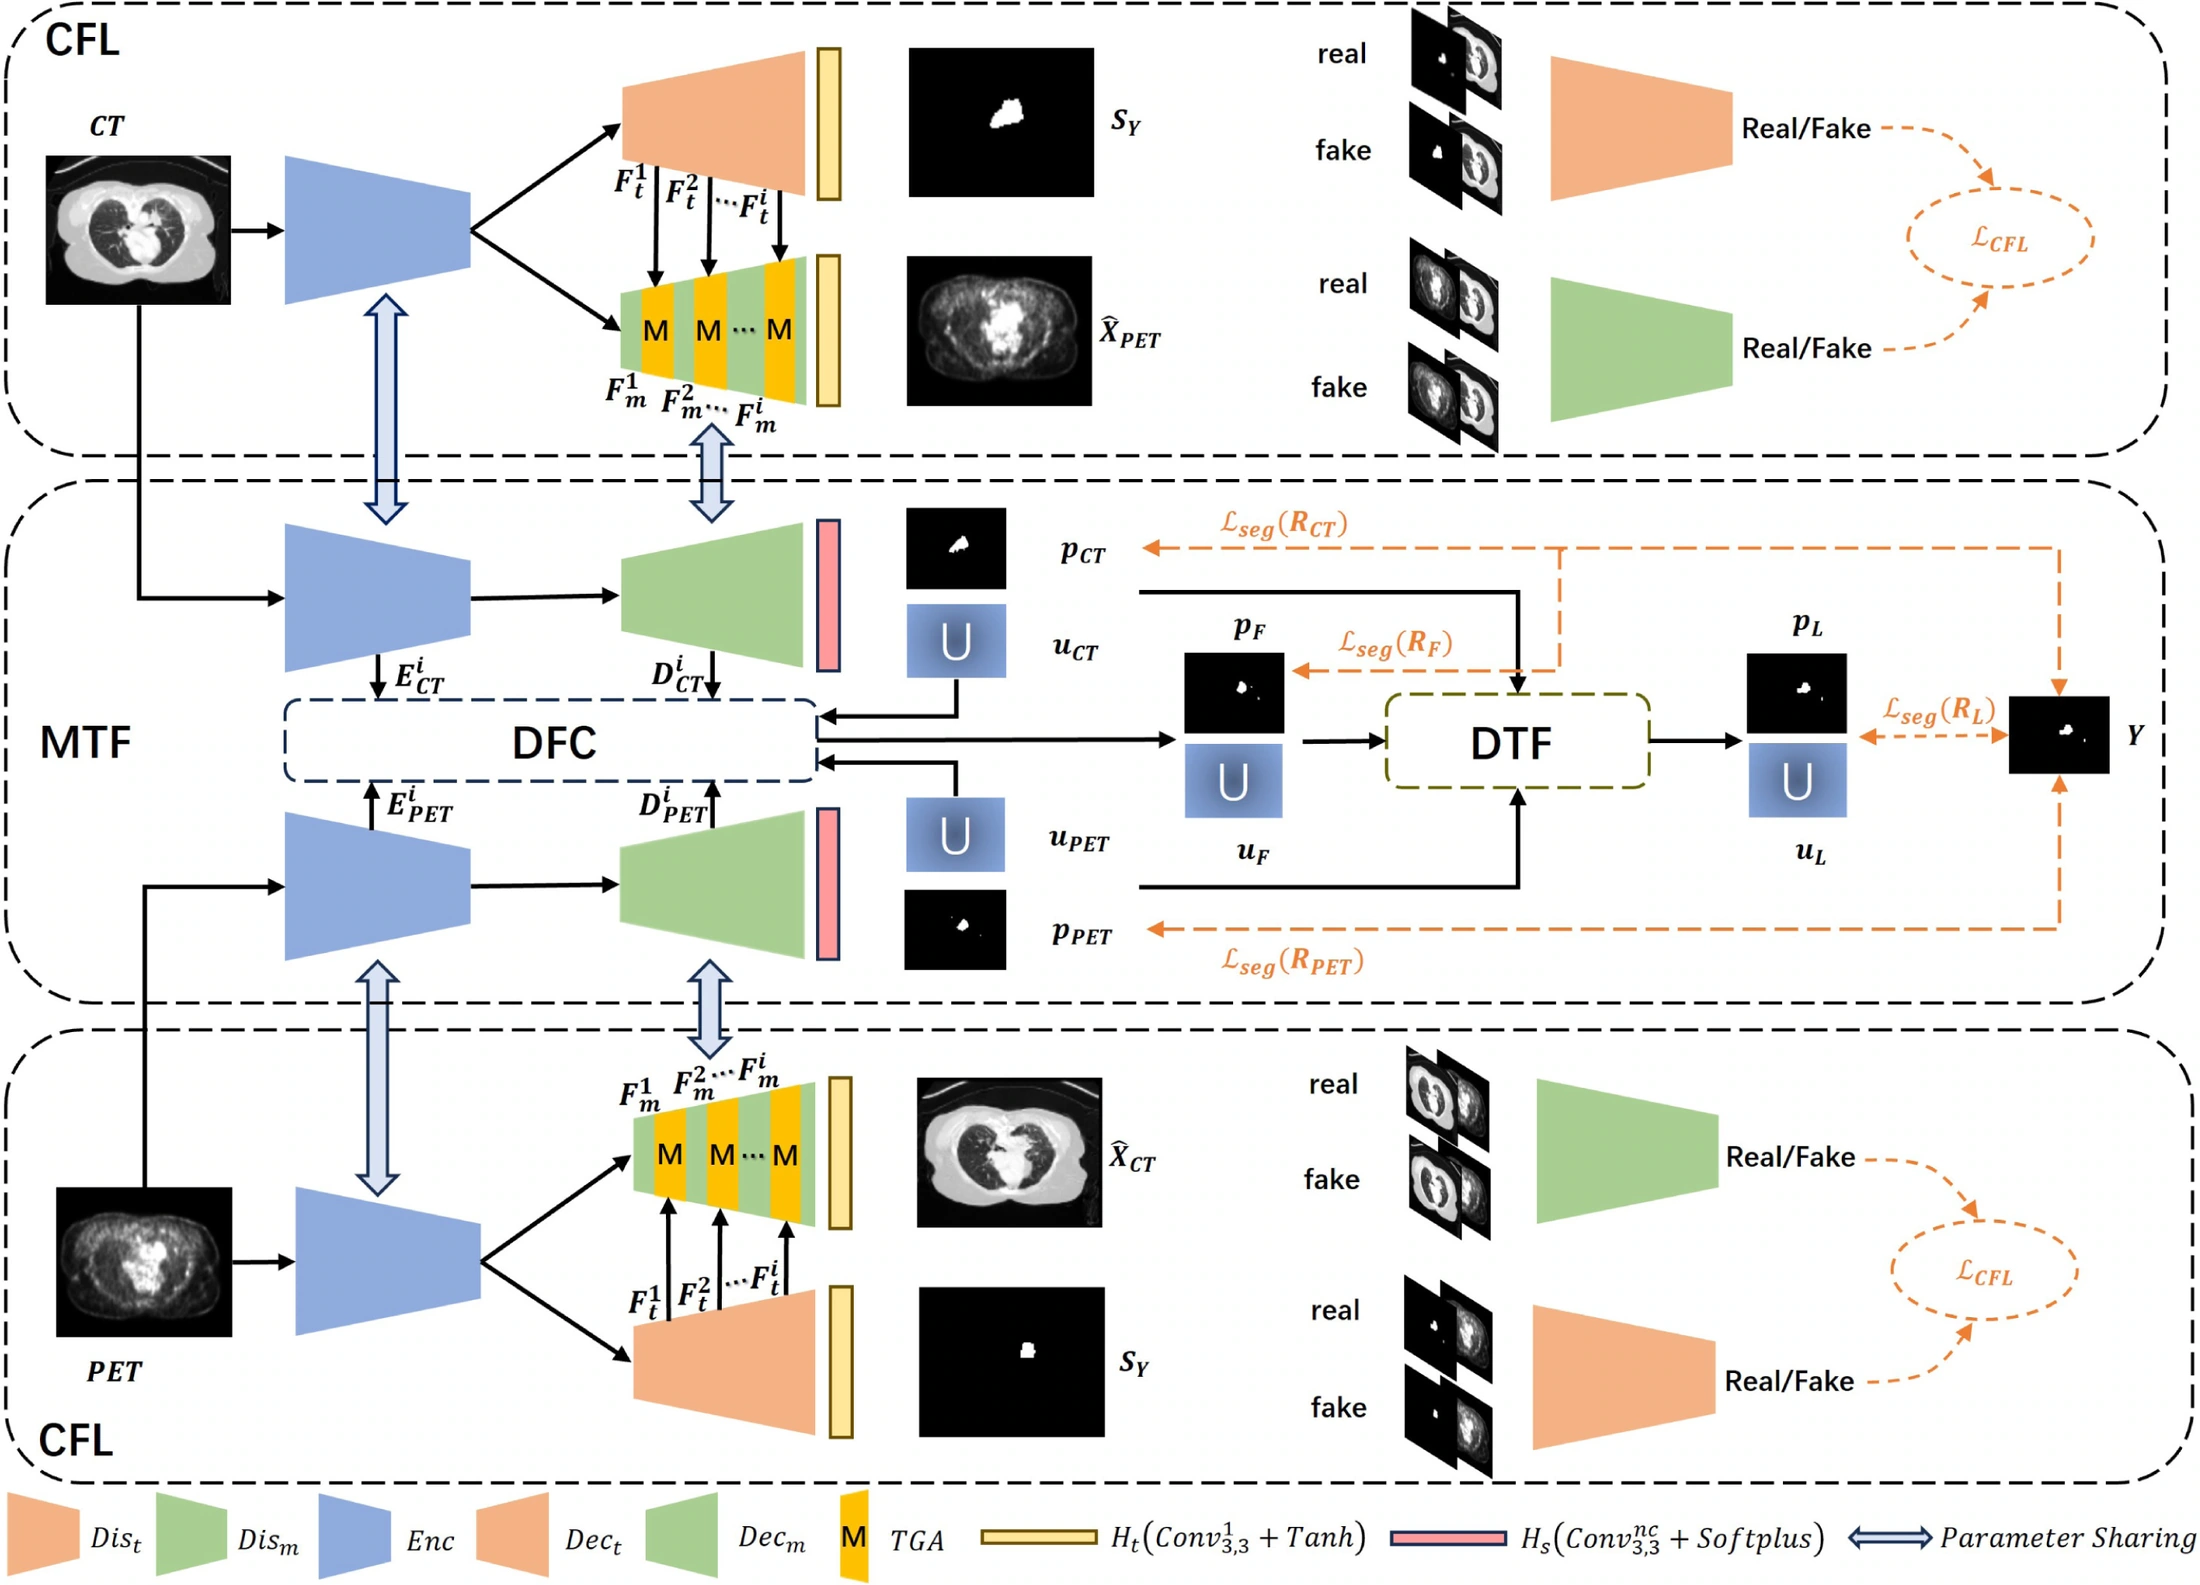
MEFN 先對齊 PET 與 CT 表徵並分別校準各模態的不確定性,再用 Dempster–Shafer 證據理論融合體素級分割證據。研究在 AutoPET 和 HECKTOR 上評估了腫瘤勾畫效果及分割不確定性。
單圖三維重建 · 科級分類監督的對比學習 · 動物姿態與形狀估計
AniMer 面向跨類羣的四足動物單目三維重建。模型以動物類羣監督的對比學習組織 Transformer 表徵,並藉助 CtrlAni3D 補充具有像素對齊網格標註的擴散合成圖像,在三維標註基準及分佈外影像上評估重建表現。
缺失模態學習 · 跨模態提示 · 無灌注區分割
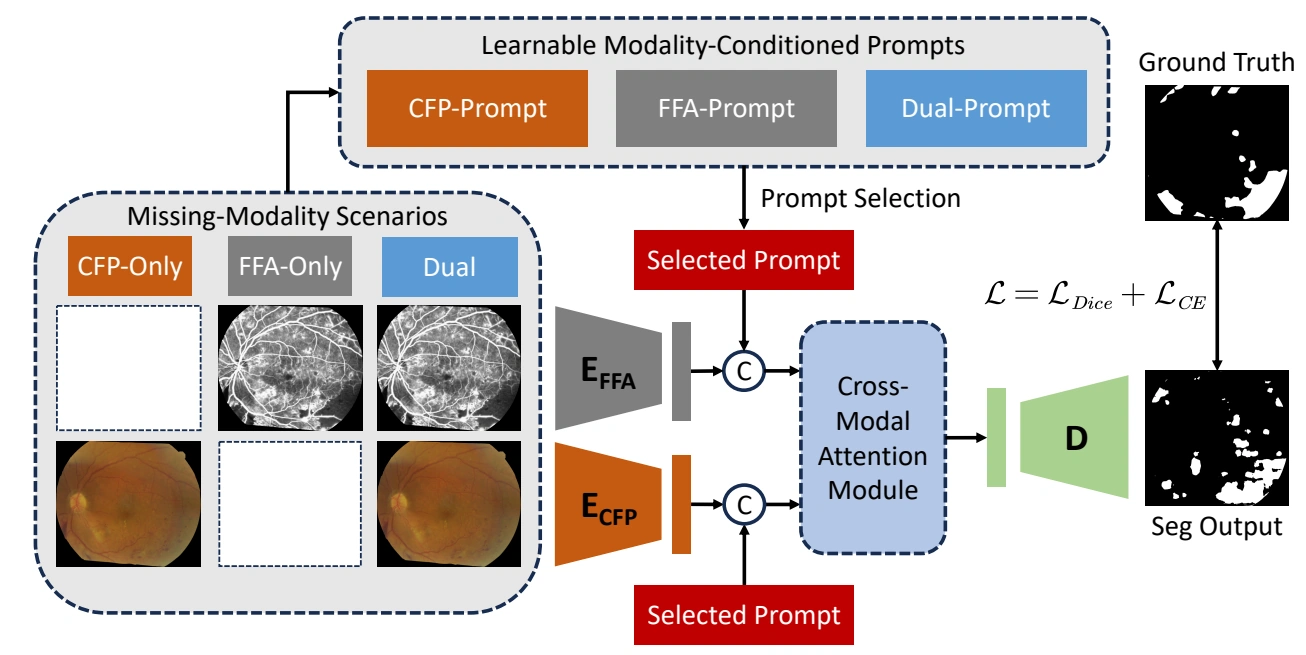
該研究將視網膜無灌注區分割建模為缺失模態學習問題。訓練時,通過模態條件提示和跨模態注意力吸收熒光造影信息,推理時僅憑彩色眼底照估計無灌注區域。
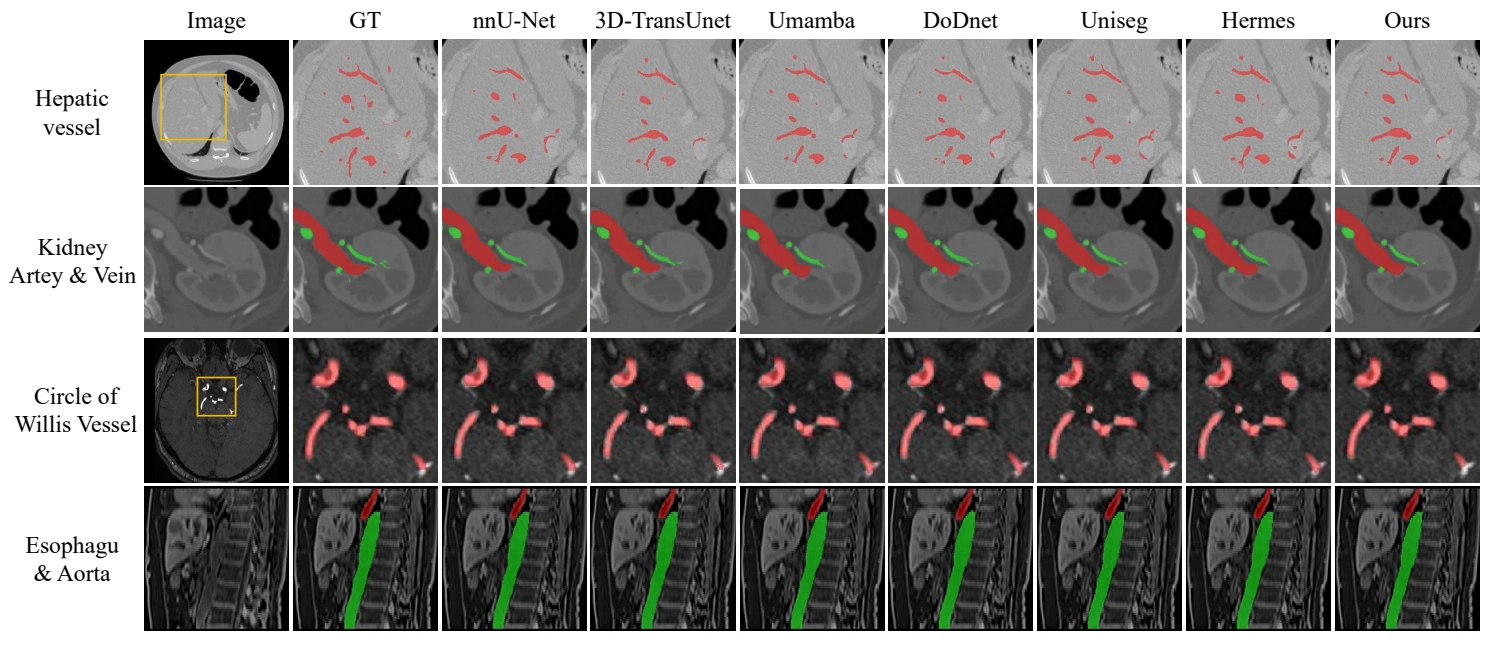
上下文提示 · 通用三維分割 · 曲線結構
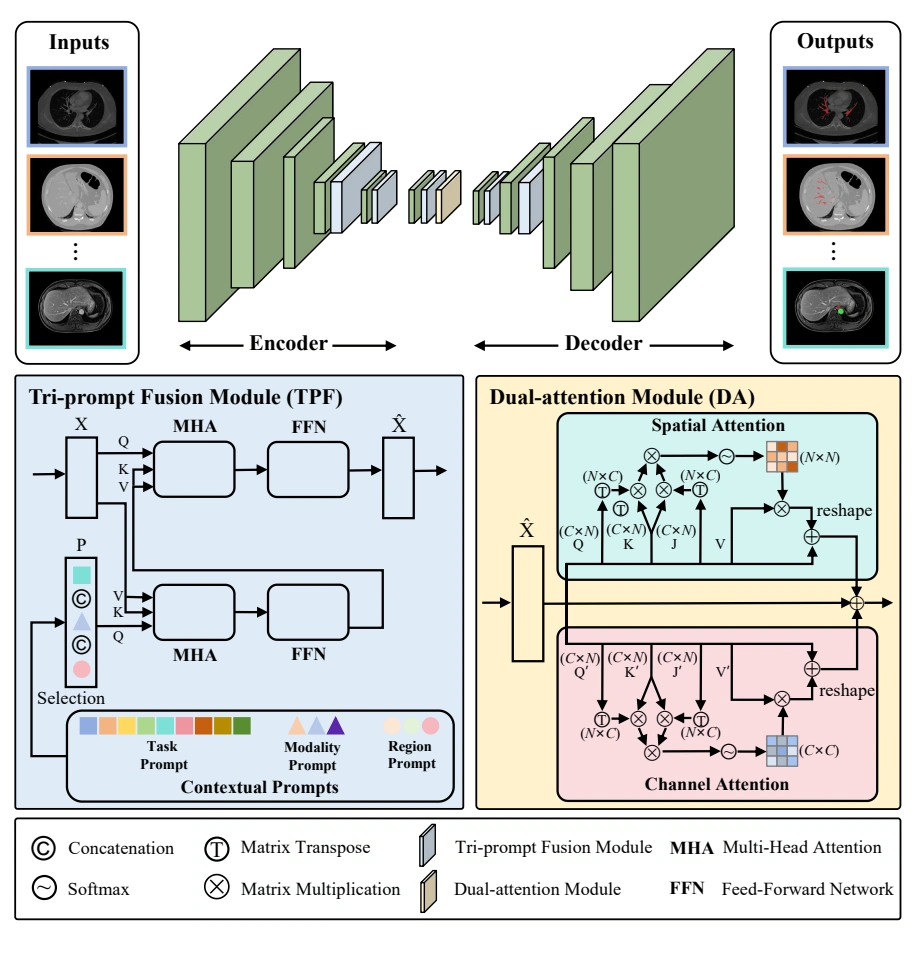
UniCurvSeg 把任務、成像模態與解剖區域編碼為上下文提示,通過交叉注意力調節共享的三維分割器。研究在覆蓋 CT、MRI 和磁共振血管成像的九個數據集上評估了血管樣結構的跨任務學習。
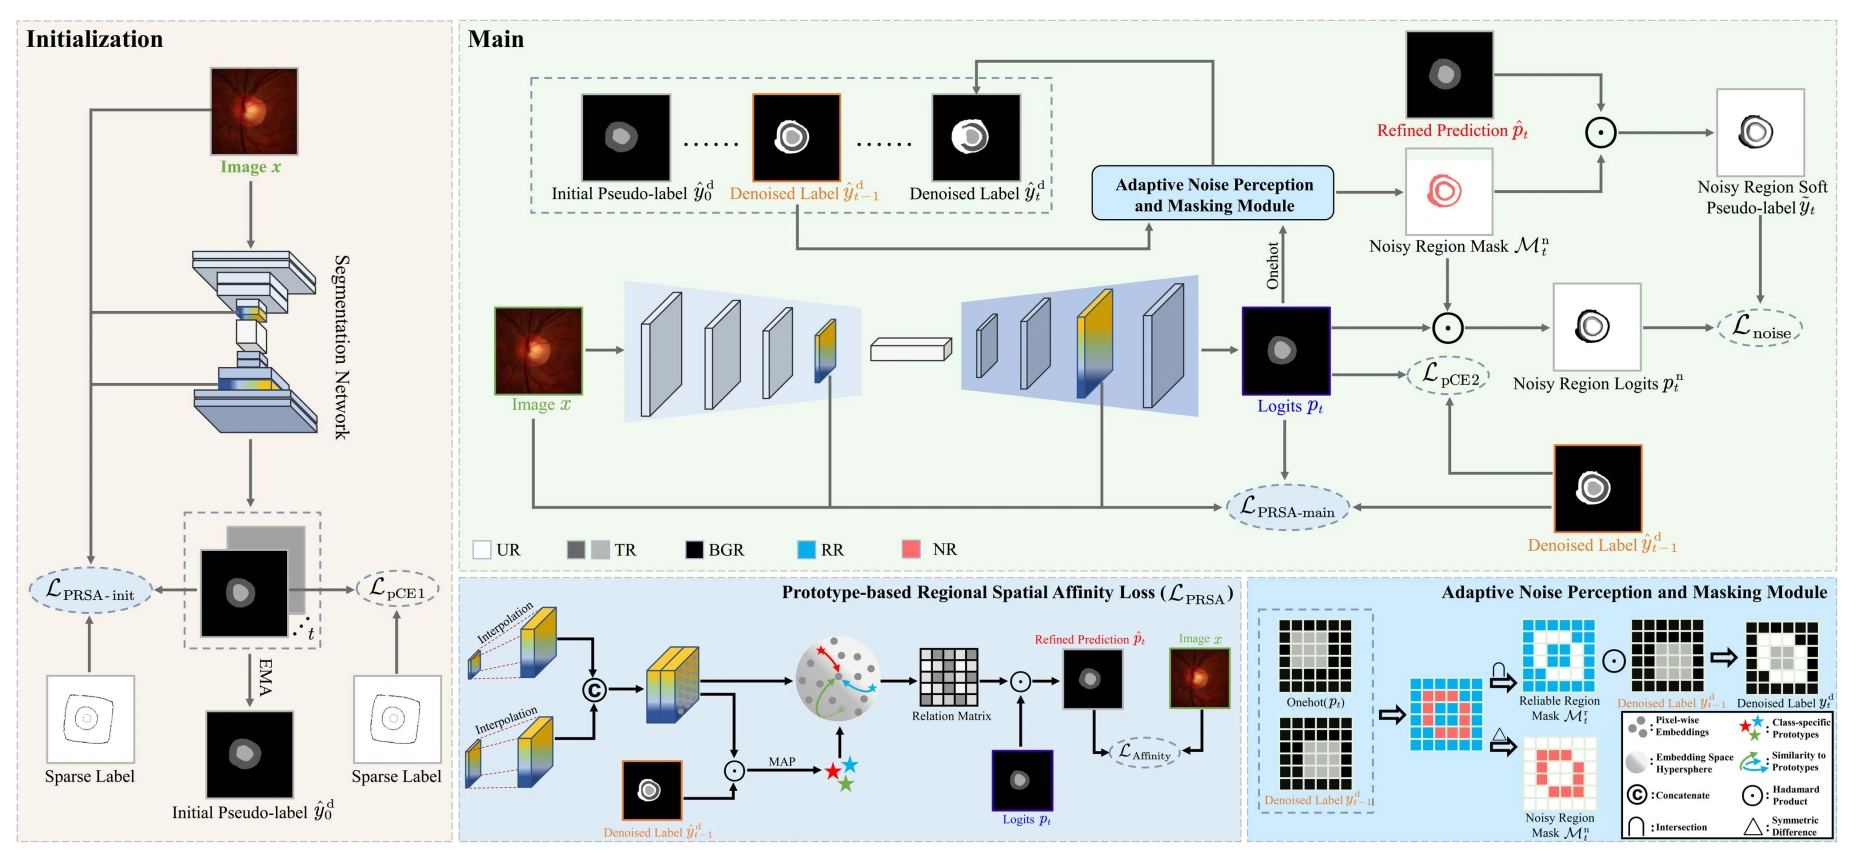
弱監督分割 · 原型校準 · 偽標籤噪聲抑制
ProCNS 針對稀疏標註擴展為稠密監督時的偽標籤誤差累積,利用校準後的原型刻畫區域的空間與語義親和性。它在更新原型時屏蔽不可靠像素,並在這些區域以軟偽標籤保留監督信號。
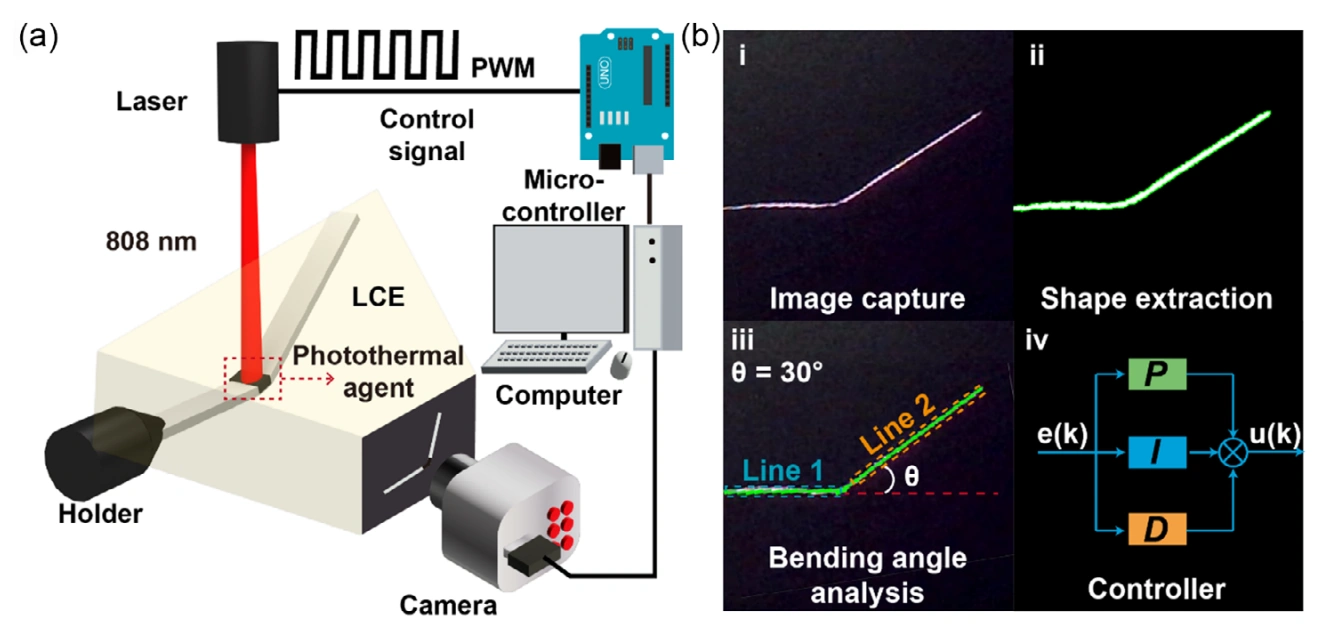
計算機視覺 · 閉環控制 · 液晶彈性體致動
該研究從視覺序列估計液晶彈性體的彎曲角度,並將測量值反饋至光驅動控制迴路,評估致動器在光照、氣流和周圍介質變化時維持目標角度的能力。
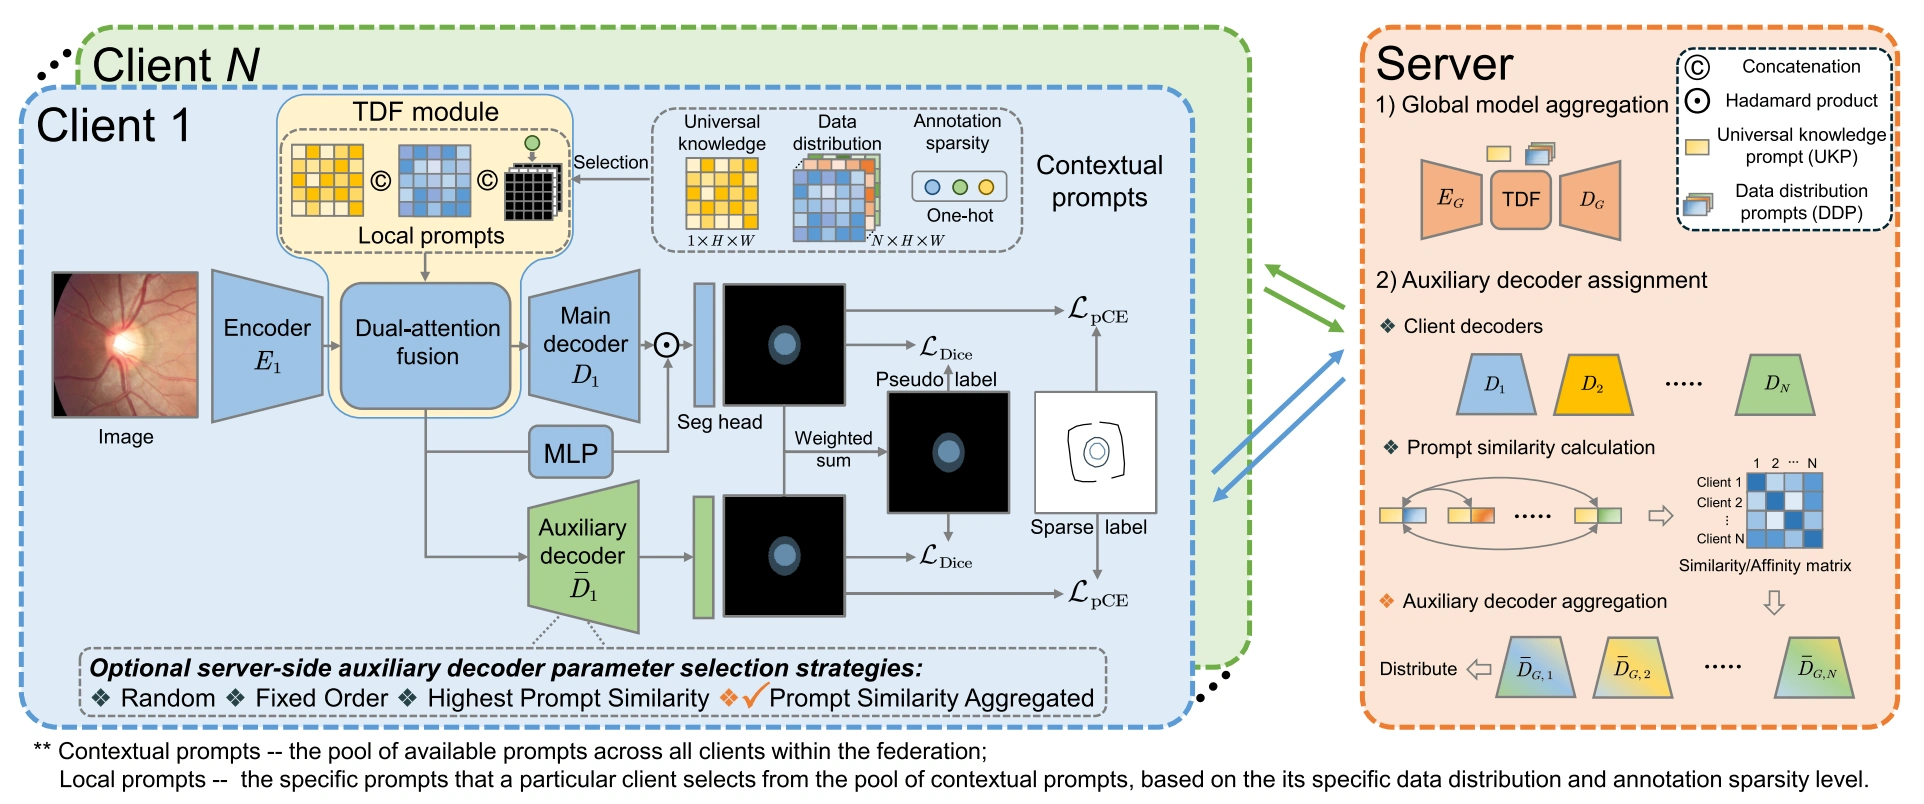
個性化聯邦學習 · 提示學習 · 異構弱監督
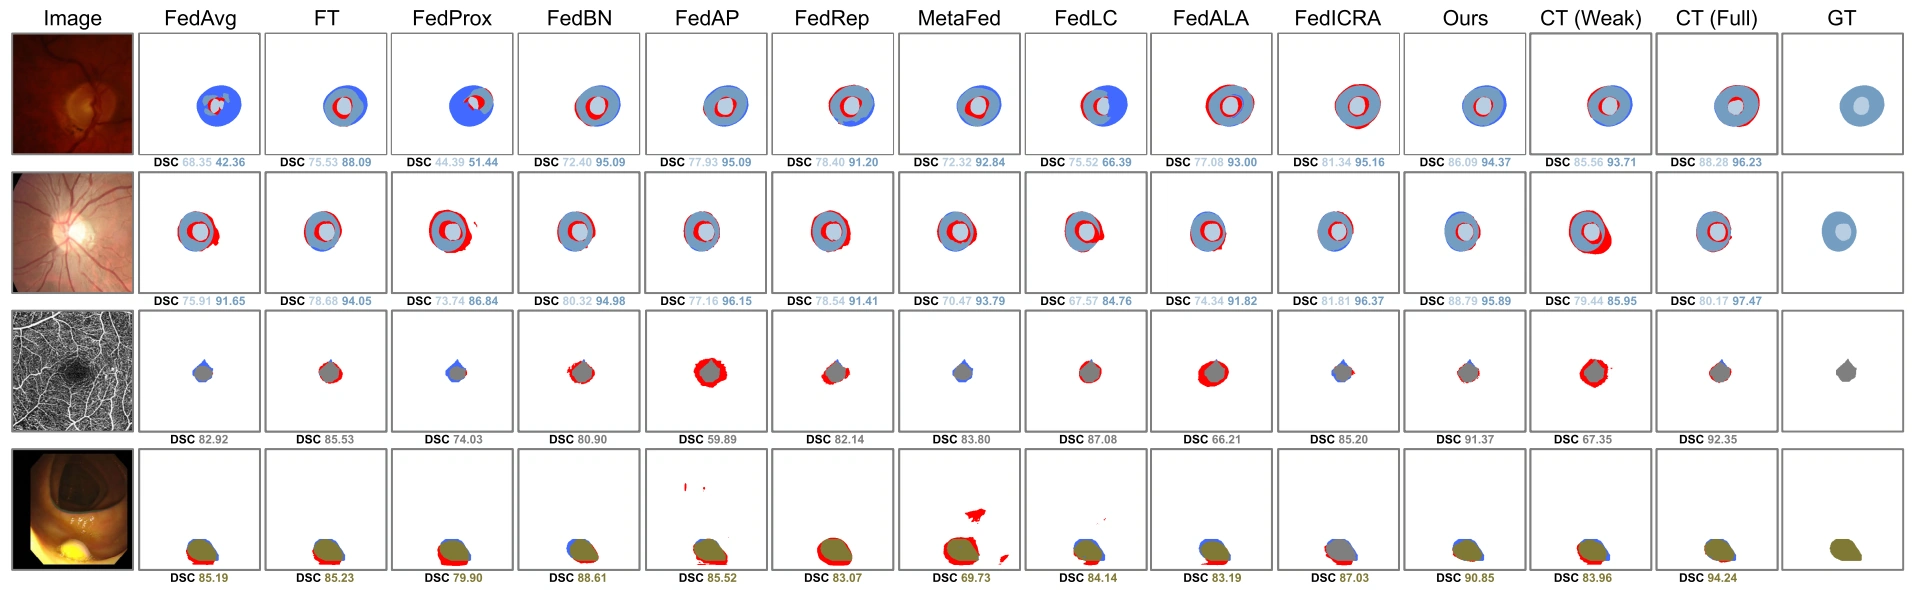
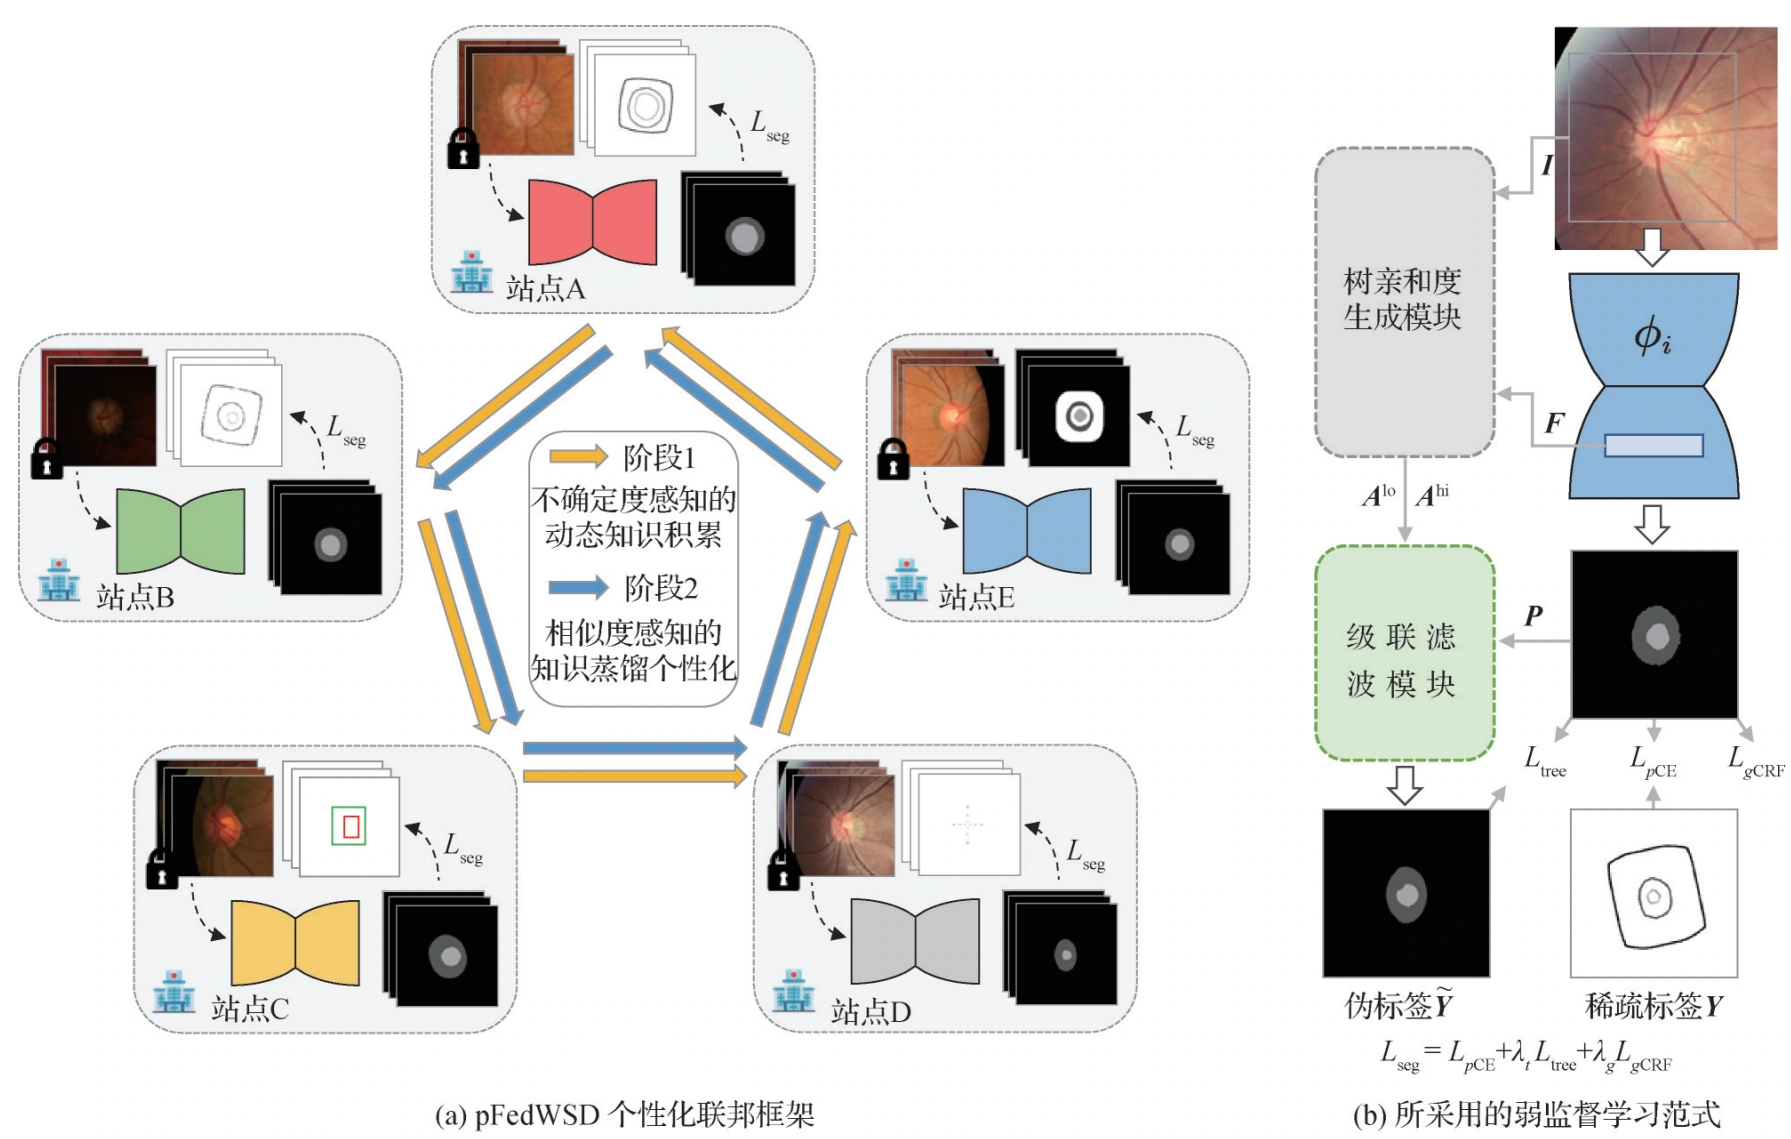
FedLPPA 將共享知識、站點影像分佈和標註稀疏性分別編碼為可學習提示。提示相似度引導雙解碼器生成偽標籤,逐參數聚合則使解碼器適配各站點。研究在四項分割任務上評估了異構弱標註下的聯邦學習。
無標註學習 · 解剖引導腫瘤合成 · 聯合分割
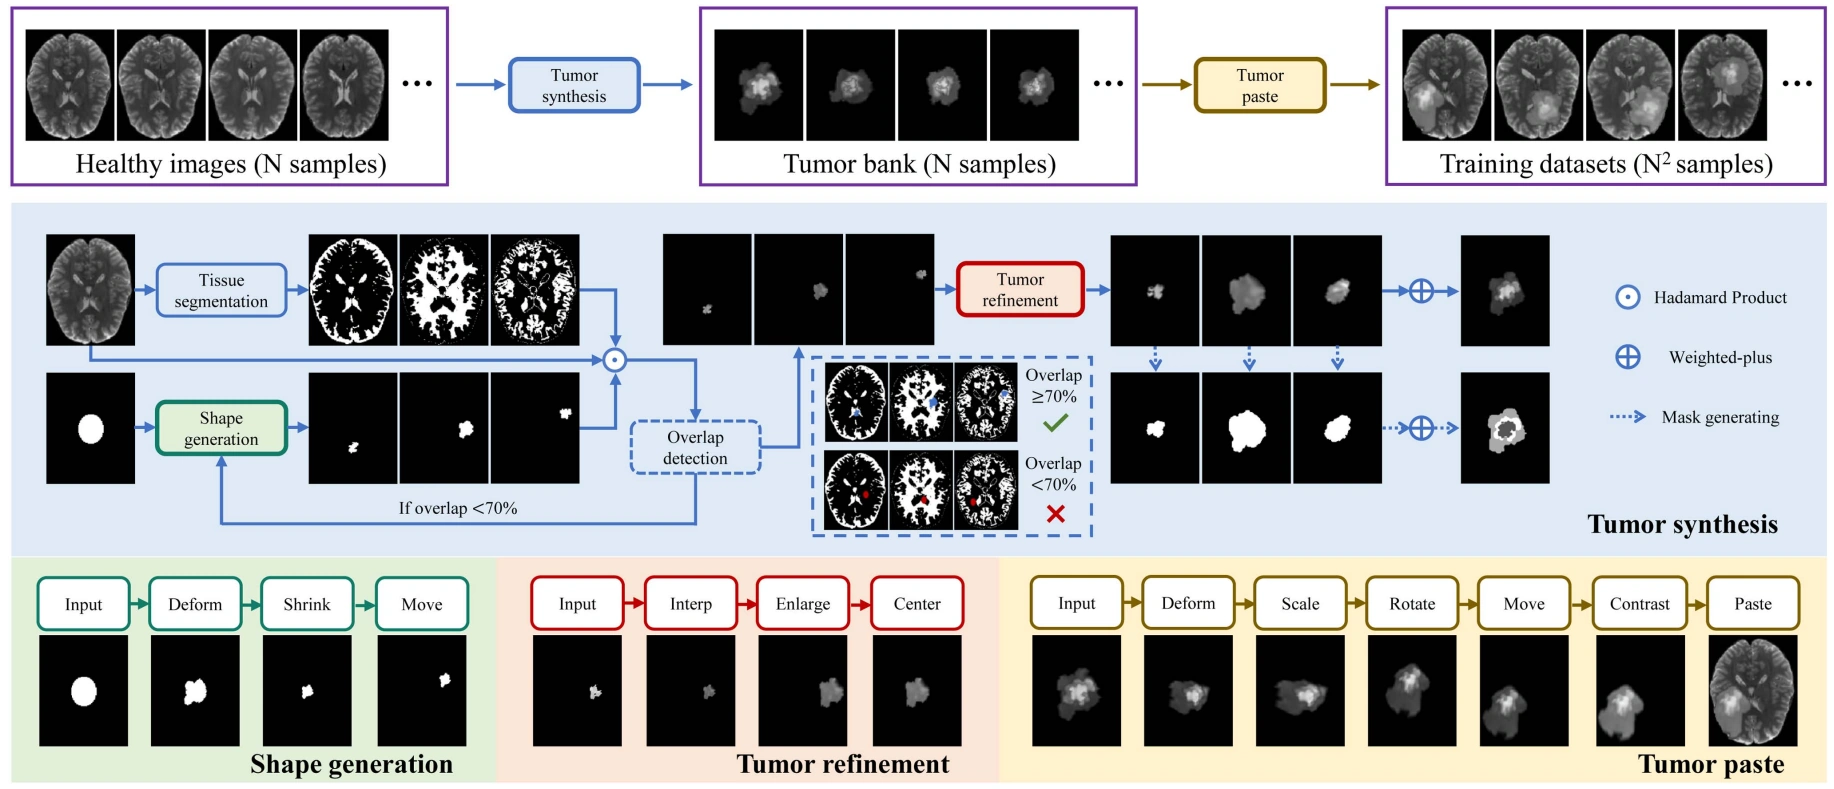
LF-SynthSeg 利用健康腦組織的強度與解剖先驗合成 T2 加權腫瘤影像,再通過腦組織與腫瘤聯合分割把解剖先驗引入訓練。研究在五個公開數據集上驗證了無需人工腫瘤掩碼的分割方案。
參數高效微調 · 特徵融合 · 高分辨率分類
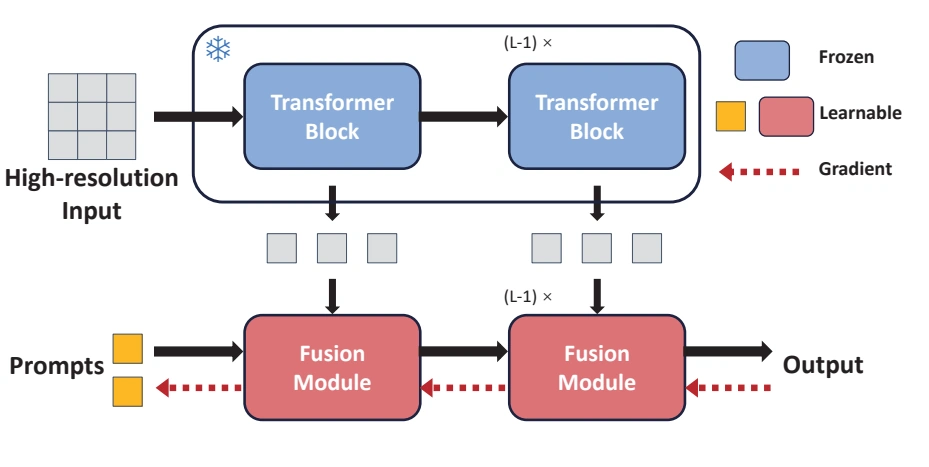
Fusion Side Tuning 凍結預訓練主幹,在輕量側路融合中間層特徵,並篩選信息量較高的圖塊標記以節省顯存。在 512 × 512 輸入和 ViT-B 主幹下,可訓練參數量與訓練顯存分別為全量微調的 2% 和 20%。
任意倍率超分辨率 · 跨對比度轉換 · 各向同性磁共振重建
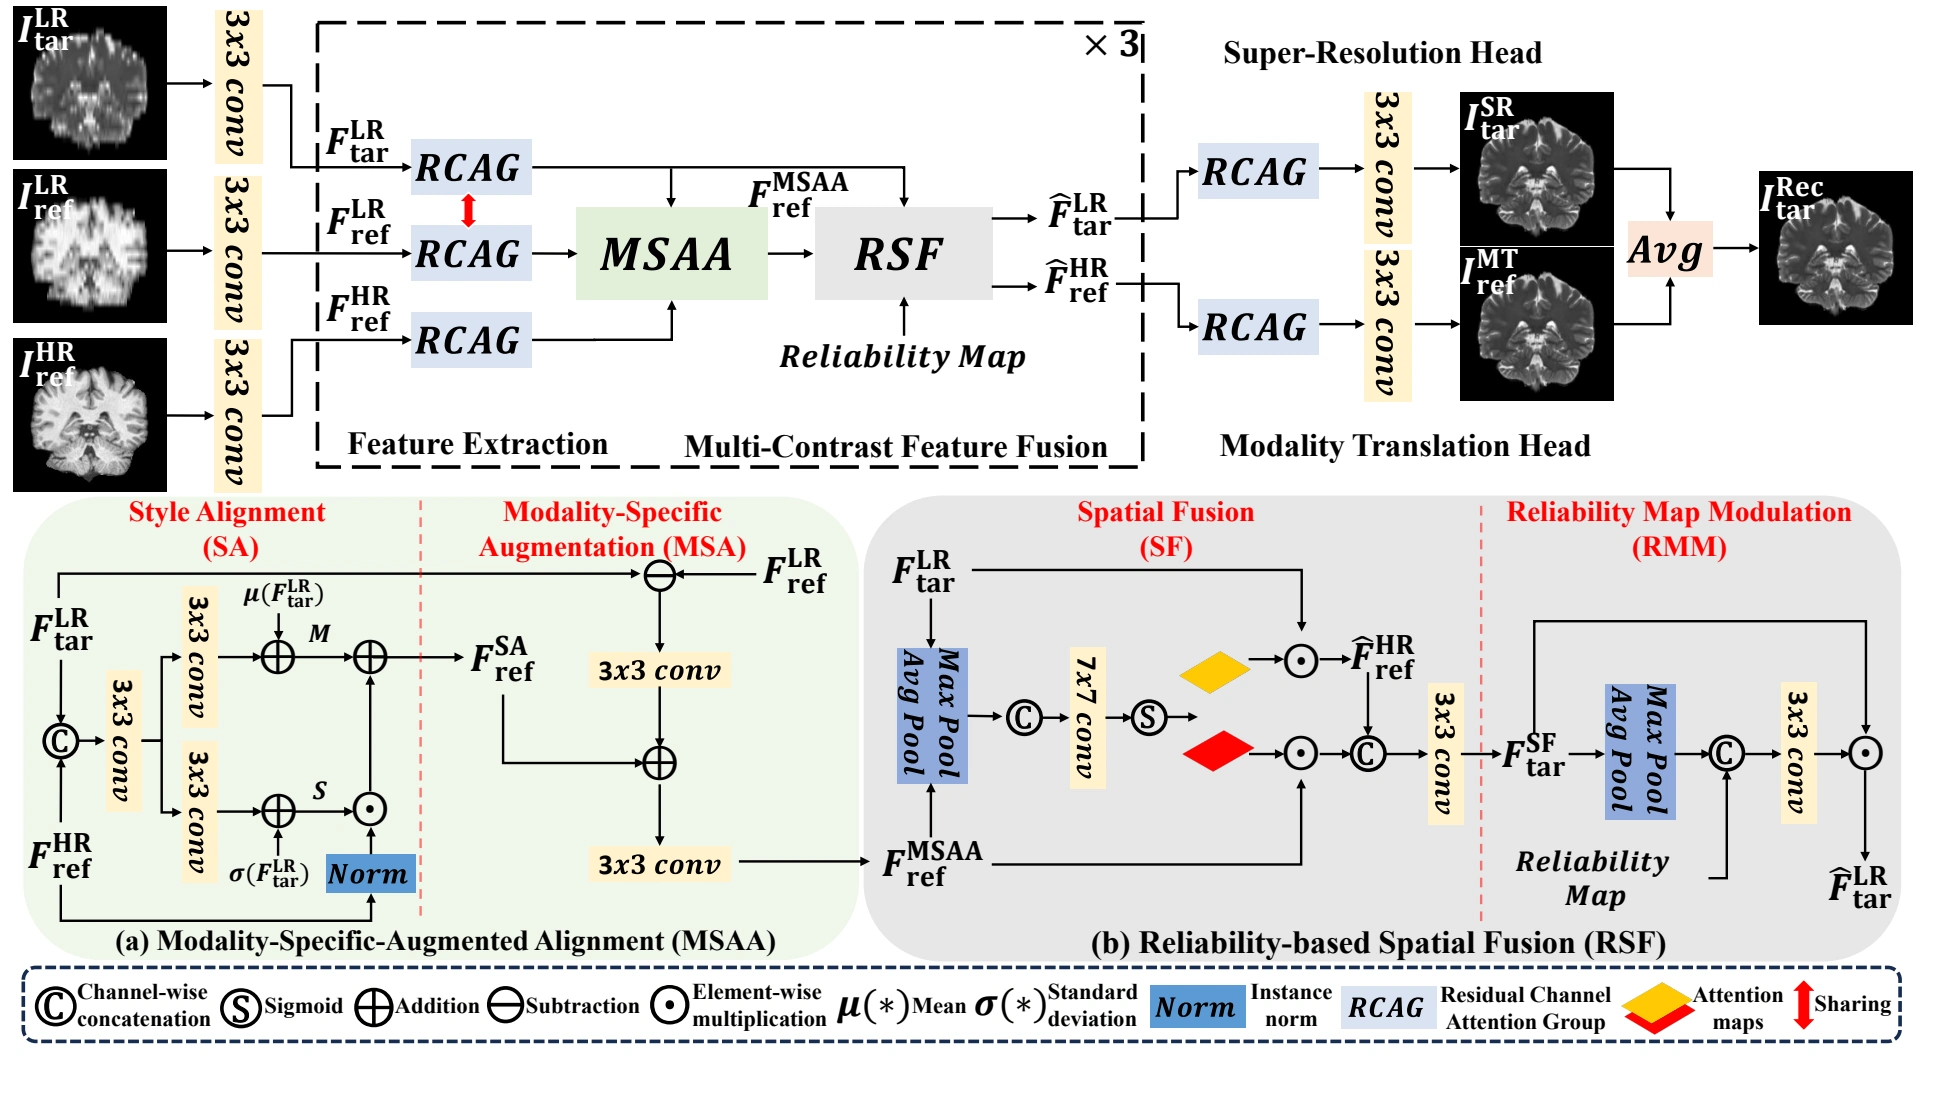
SMNet 利用各向異性掃描與高分辨率參考序列,在不同上採樣倍率下重建各向同性 MRI。兩個分支分別處理跨對比度對齊與空間細節恢復,並通過可靠性加權控制參考特徵對重建的貢獻。
掩碼建模 · 自監督預訓練 · 多模態磁共振分割
MMCM 對不同 MRI 序列施加互補掩碼,使被遮蓋區域的重建依賴其他序列的表徵。研究在 BraTS 2021 上檢驗了自監督編碼器對腦腫瘤分割的遷移,包括少樣本訓練和單序列輸入兩種條件。
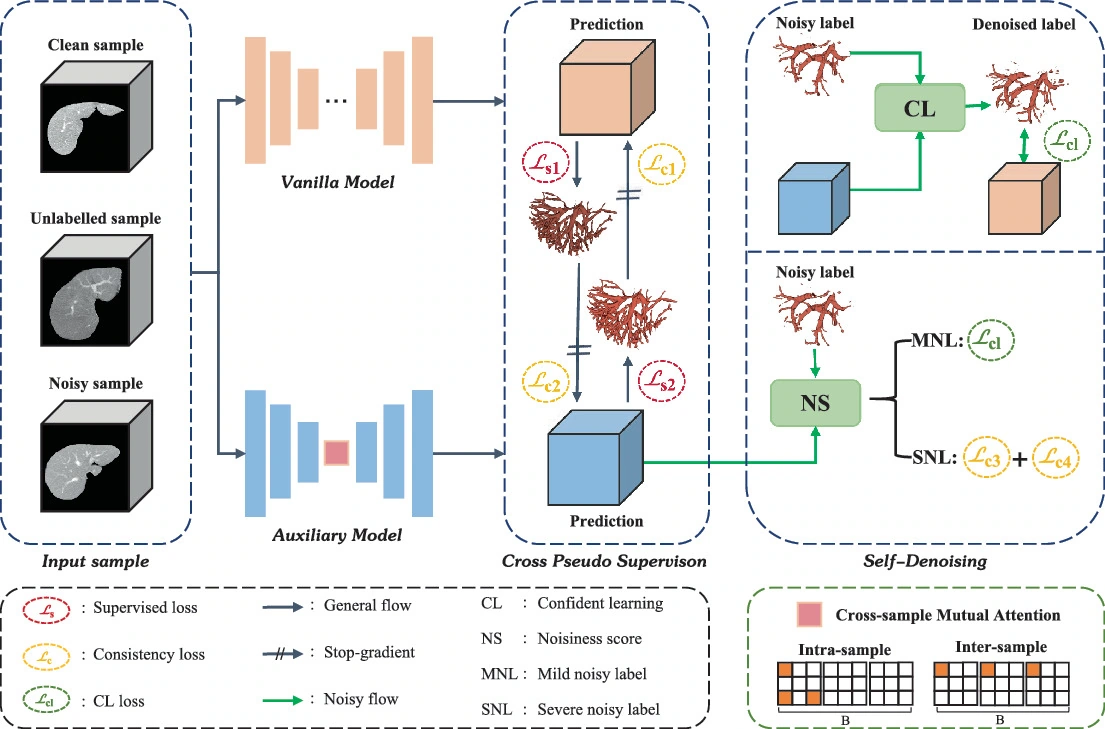
混合監督 · 交叉監督 · 標註去噪
CSSD 將少量高質量標註、較多含噪標註和未標註 CT 納入同一肝血管分割框架。跨樣本注意力傳遞較乾淨的標註線索,雙網絡一致性與自去噪分別利用未標註和含噪樣本。
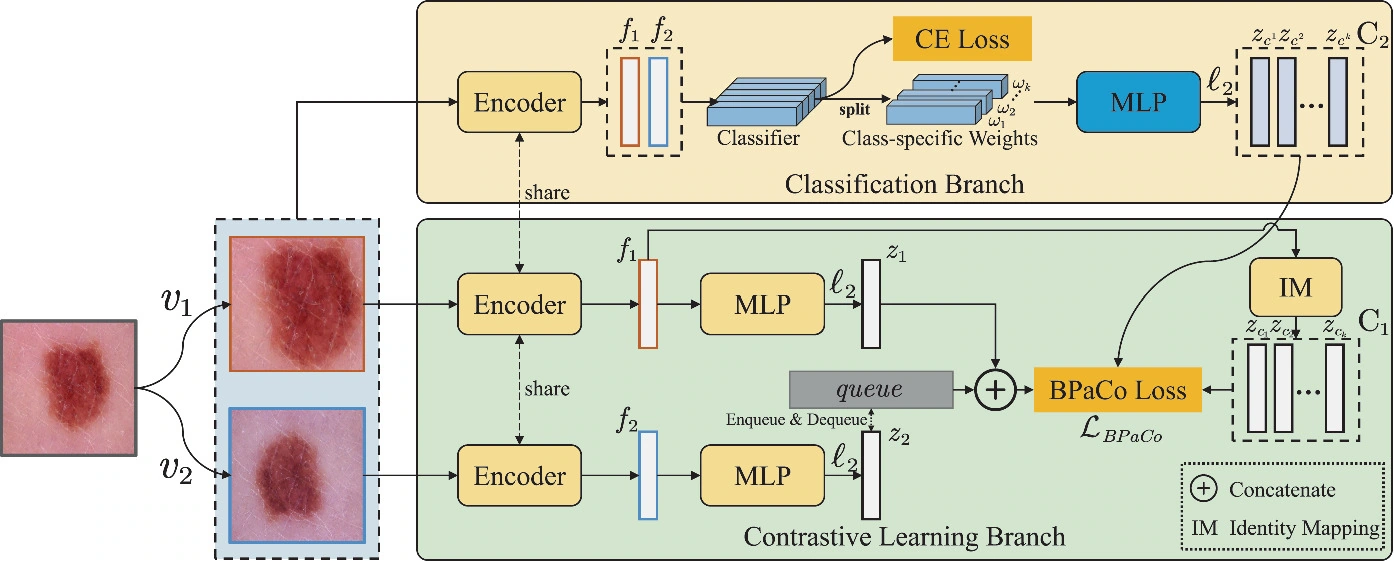
長尾識別 · 均衡參數化對比學習 · 分類分數補償
BPaCo 從表徵學習入手處理醫學影像分類的長尾分佈。跨批次類別平均平衡負類梯度,類別補全使少數類也能參與每個小批次的對比訓練,分類分支則通過 logit 補償進一步糾正類別偏斜。
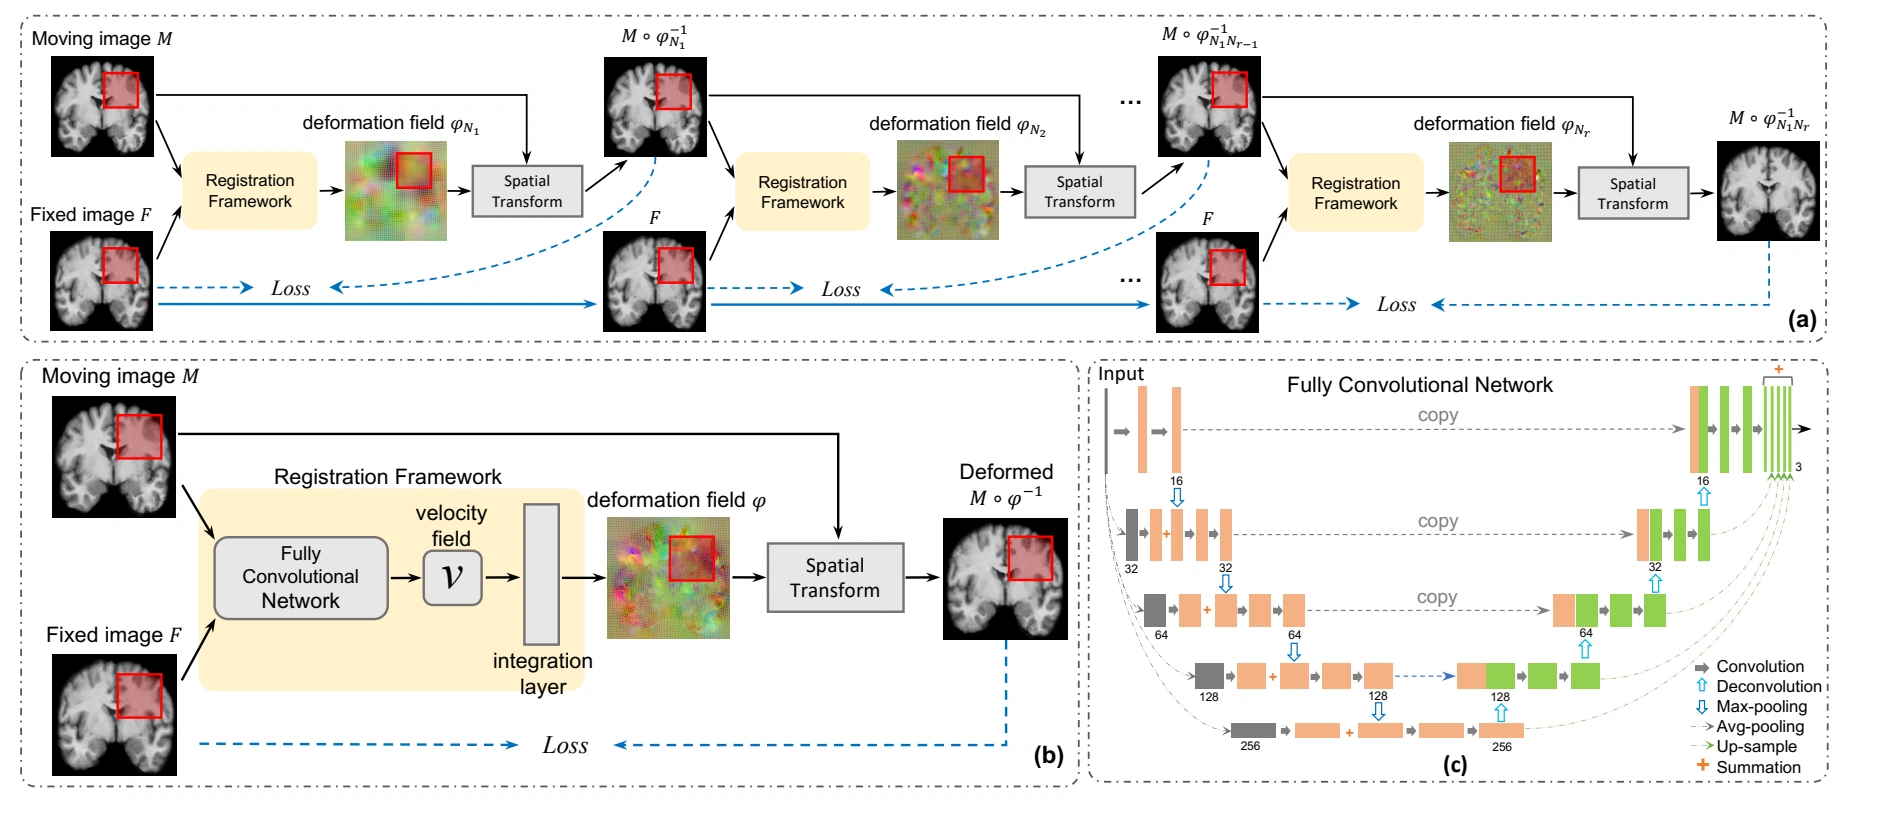
無監督微分同胚配準 · 圖塊學習 · 拓撲保持
該方法用無監督全卷積網絡從 MRI 圖塊估計局部形變,並以微分算子約束粗到細配準中的速度場。研究在三個 T1 加權 MRI 數據集上評估了配準精度與解剖拓撲保持。
半監督分割 · 基礎模型適配 · 雙教師學習
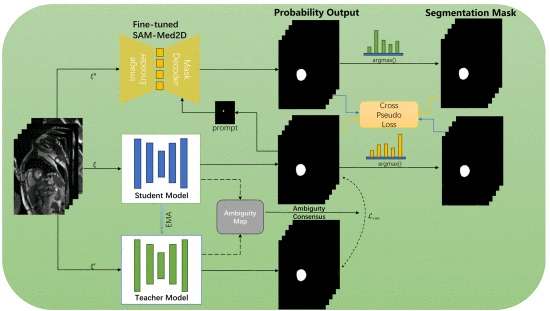
S-ACMT 將經過領域微調的 SAM-Med2D 引入半監督醫學分割,作為第二教師。其偽標籤與任務教師的偽標籤互補,從兩種監督來源學習未標註影像。
多模態自監督預訓練 · 熵引導掩碼 · 二維與三維眼科影像
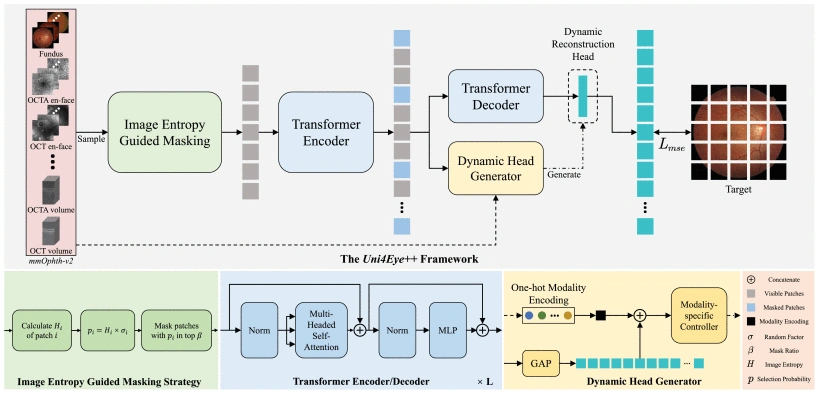
Uni4Eye++ 將無標註二維眼科影像與三維體數據納入同一掩碼預訓練框架。圖像熵引導模型重建信息豐富的區域,動態重建頭適配不同模態的成像特徵,共享編碼器隨後遷移至分類和分割。
解剖先驗 · 由粗到細的精細化 · 多任務學習
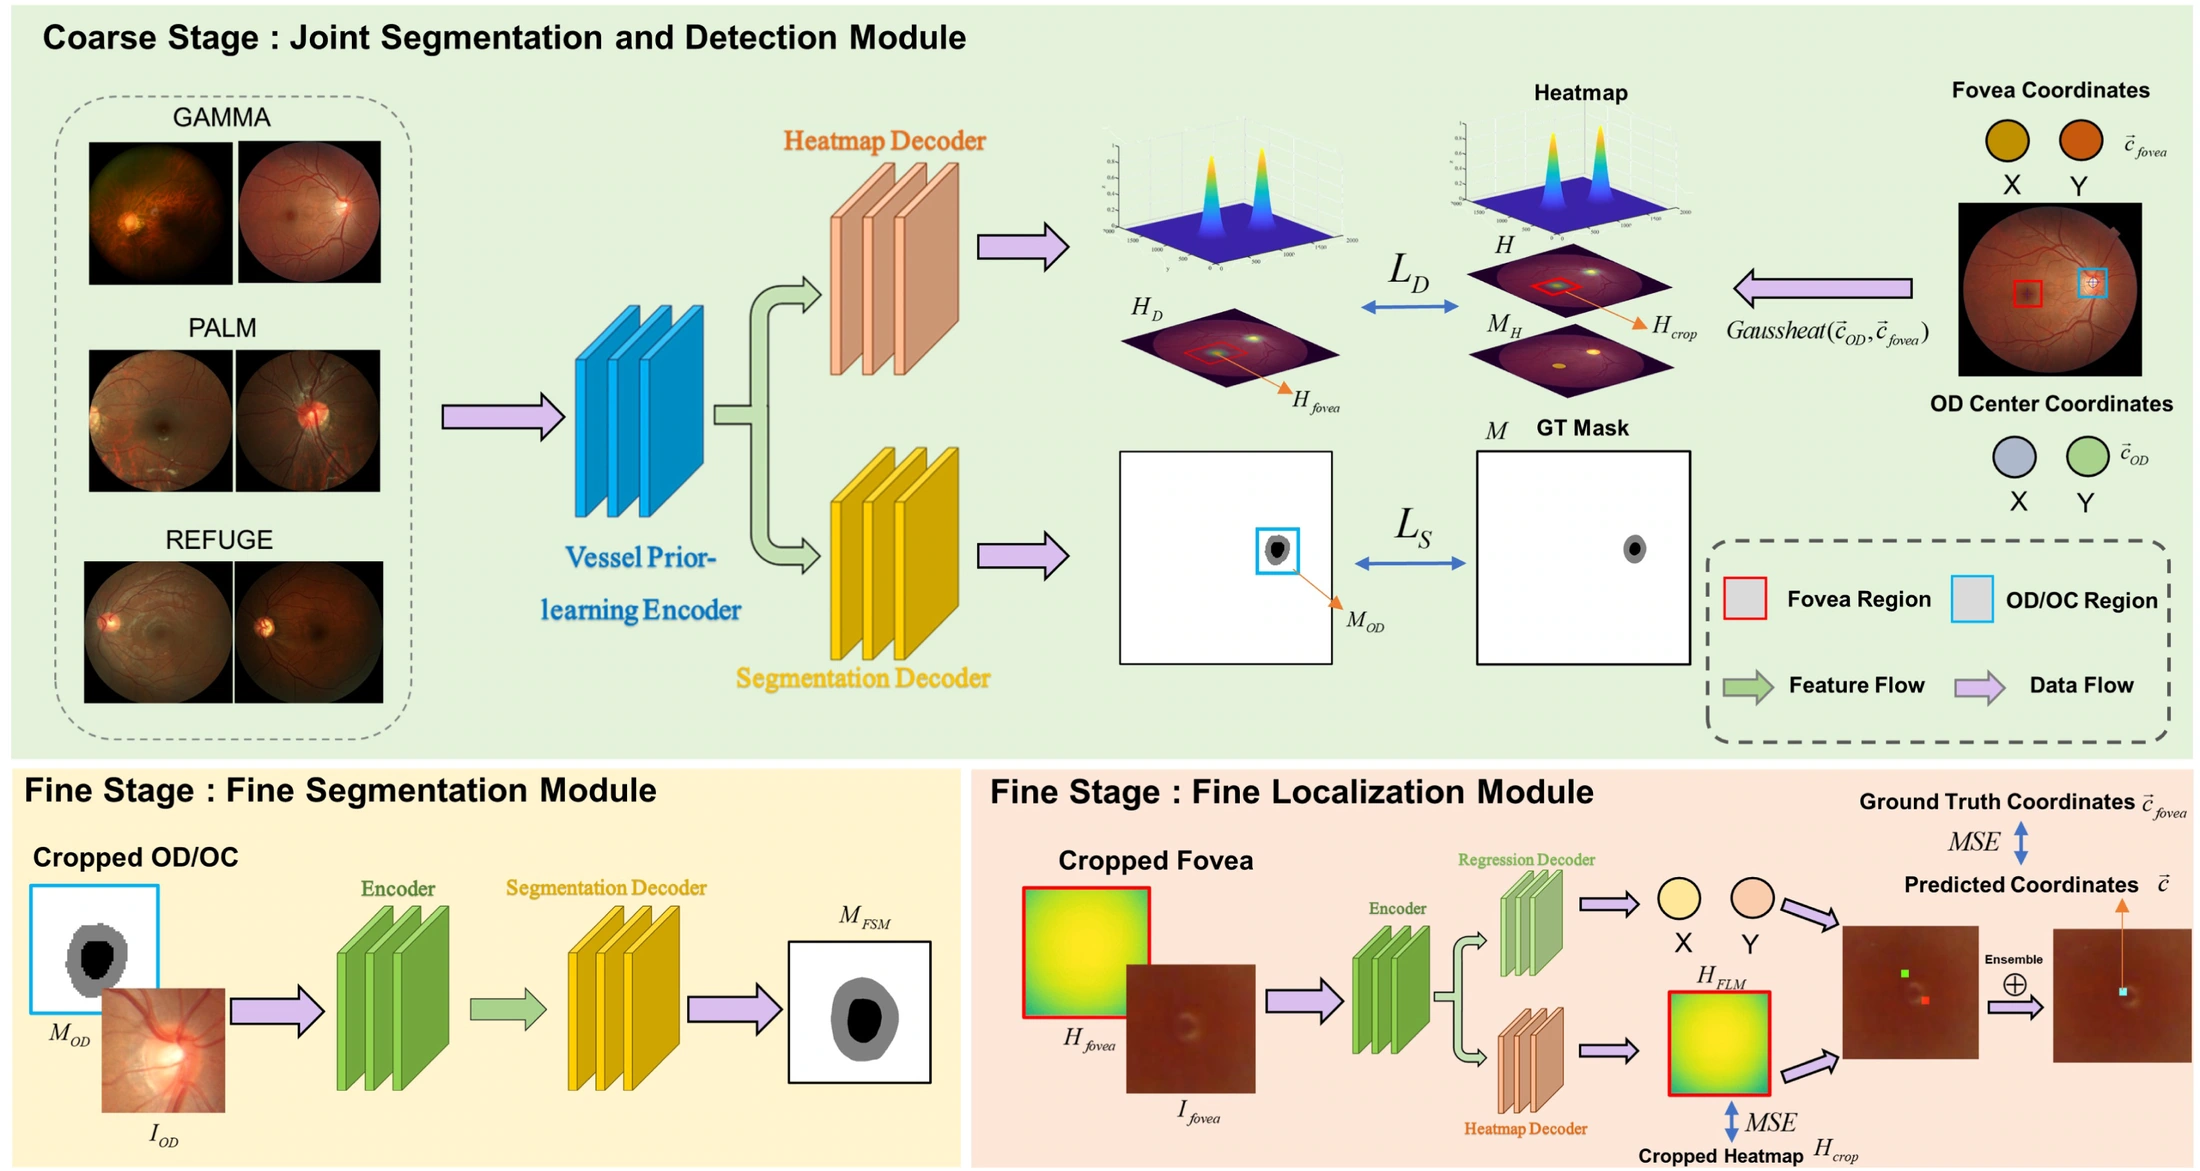
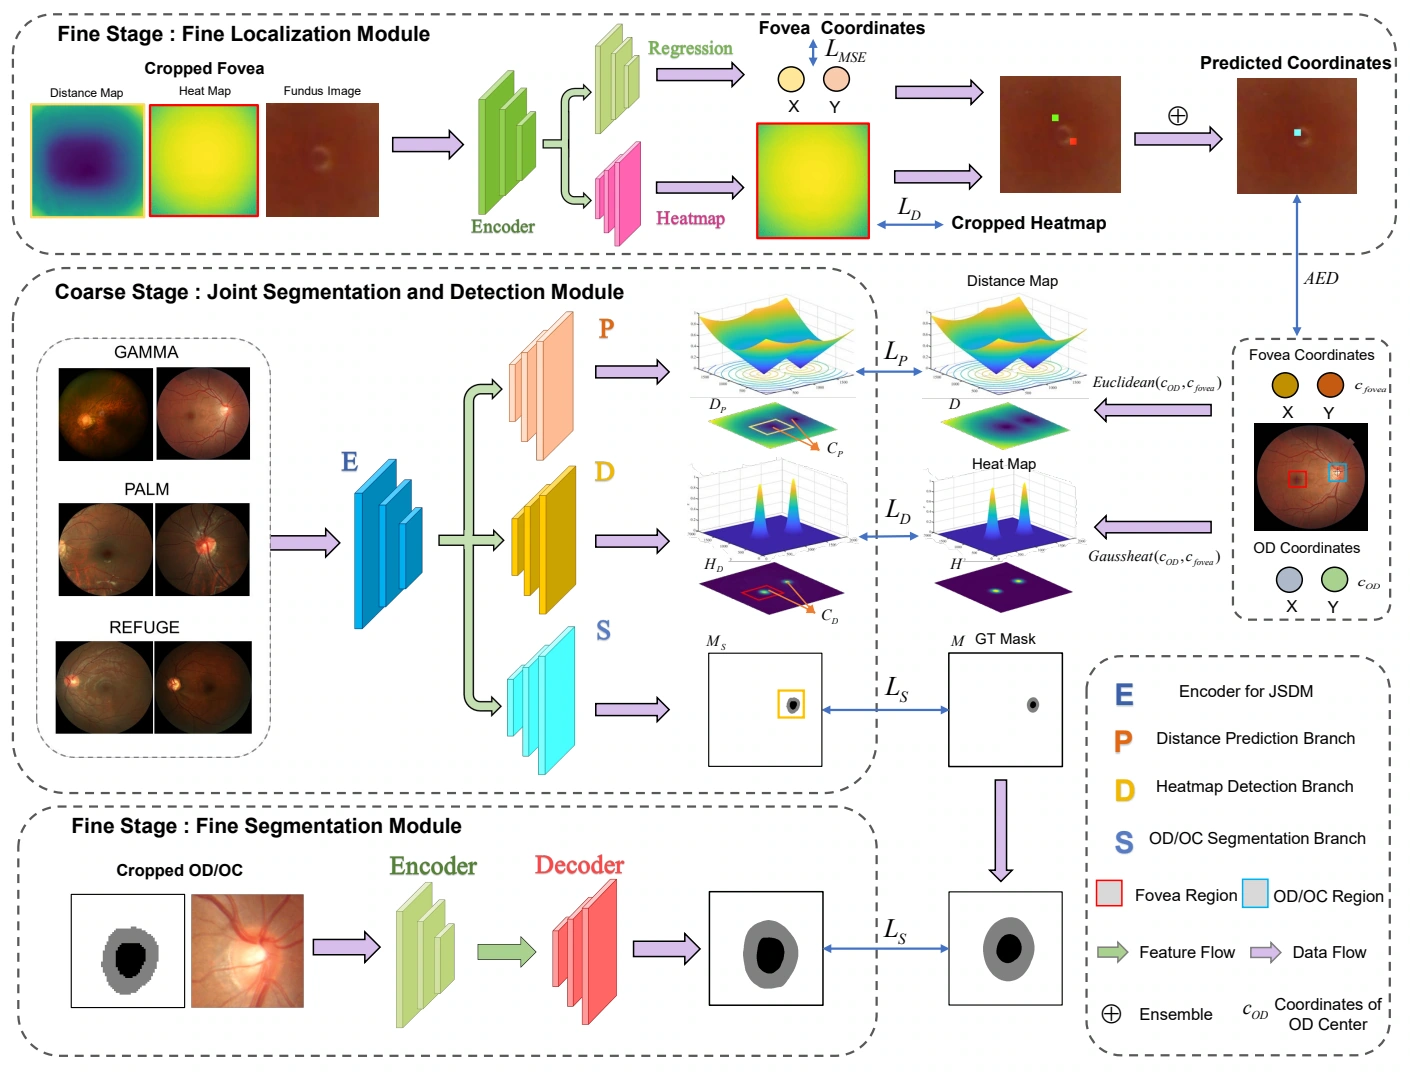
JOINEDTrans 從視網膜血管分割中學習空間先驗,並遷移到視盤、視杯分割與黃斑中心定位。粗到細的 Transformer 以初步預測引導局部精修,並在 GAMMA、REFUGE 和 PALM 三個數據集上驗證。
半監督學習 · 基礎模型適配 · 迭代偽標籤
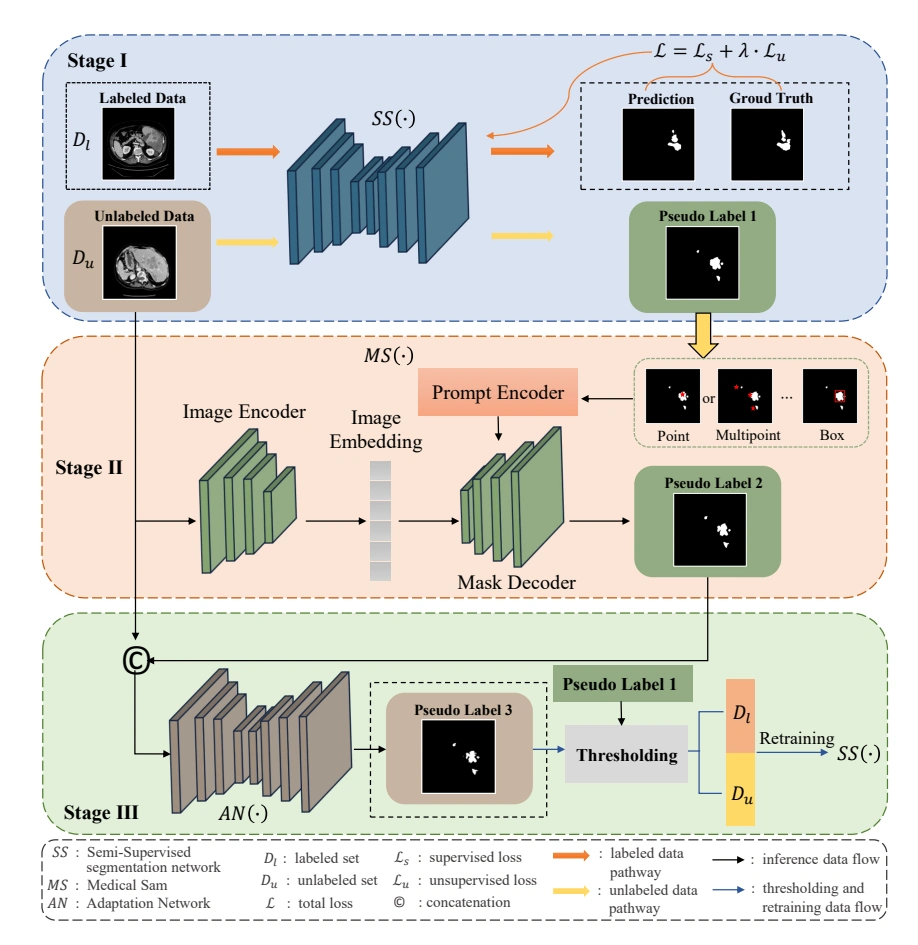
ASLSeg 將 Segment Anything 模型(SAM)納入半監督肝腫瘤分割的迭代流程。任務分割器提供提示,適配網絡細化 SAM 掩碼,再將高置信度的結果納入有標註訓練集。
長尾識別 · 顯著性引導混合增強 · 皮膚鏡圖像分類
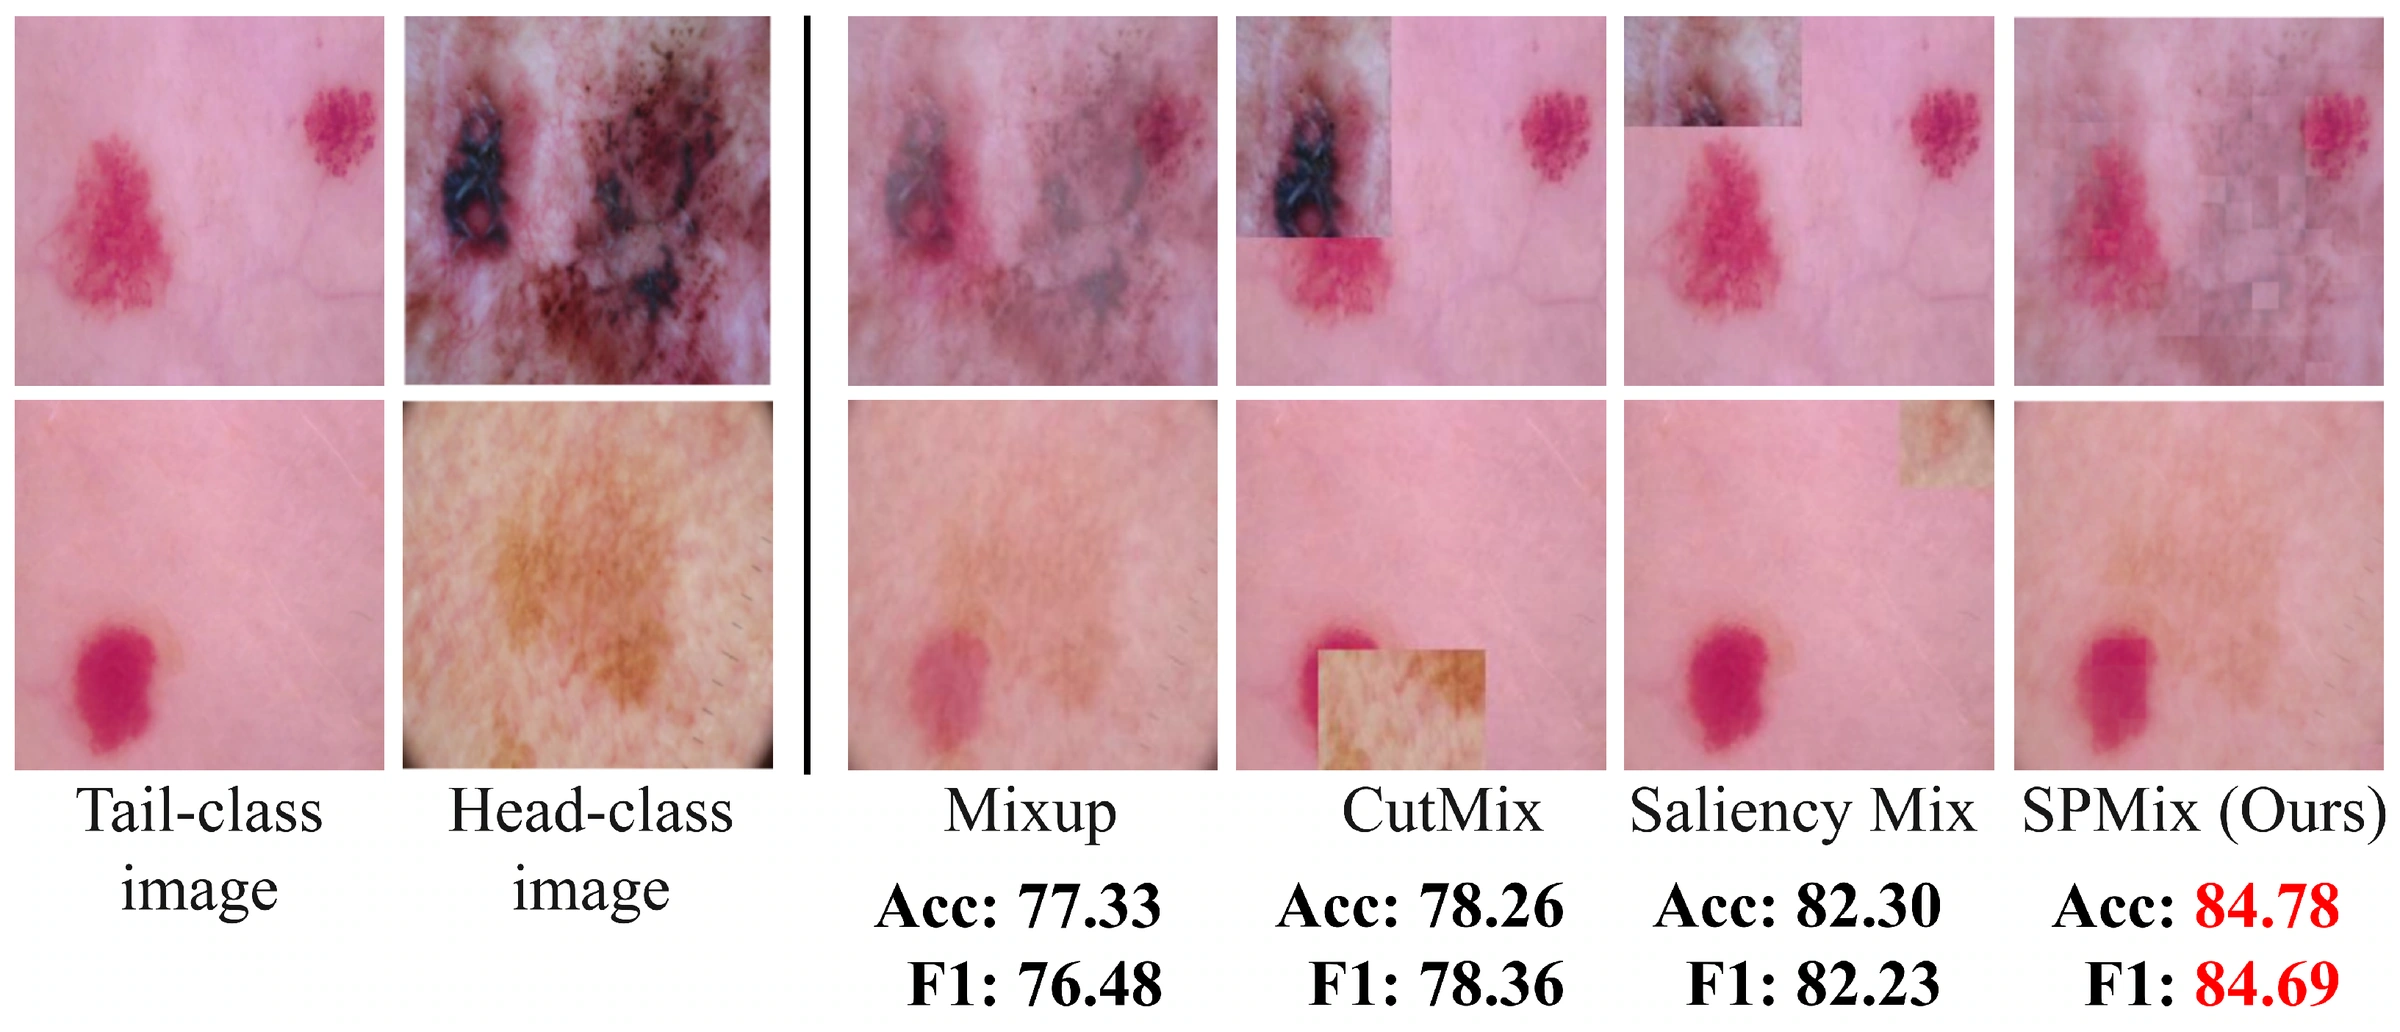
SPMix 用病灶顯著性決定皮膚鏡圖像中參與混合的區域,為長尾分類構造少數類訓練樣本。合成樣本保留有判別力的病灶區域,同時從常見類別引入更多圖像變化。
視覺語言模型 · 參數高效適配 · 長尾識別
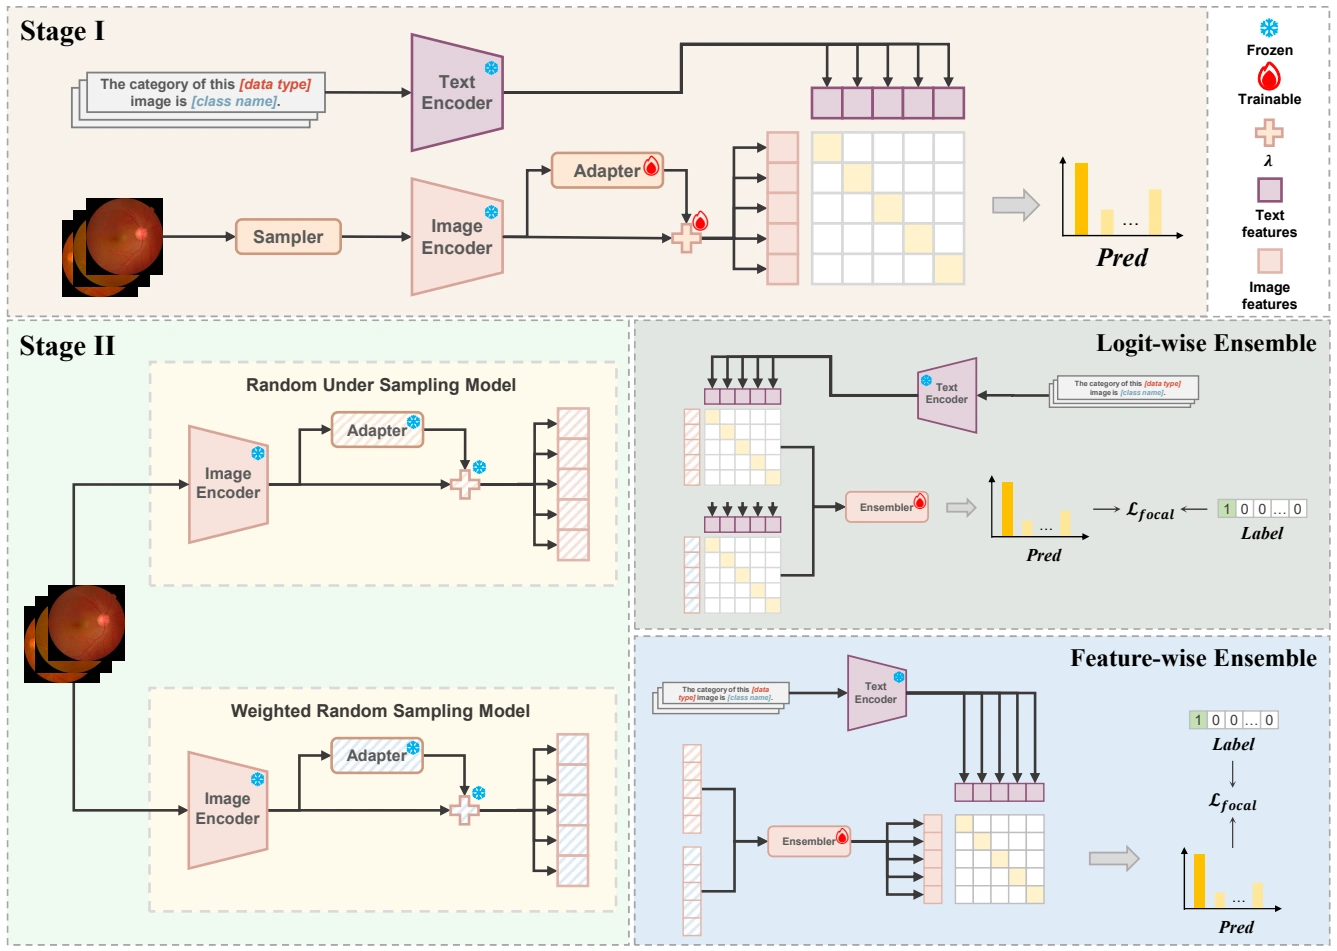
TFA-LT 探索視覺語言基礎模型在醫學影像長尾分類中的輕量適配。方法分兩階段訓練兩個線性適配器和一個集成分類頭,並在兩個類別不均衡的數據集上評估分類表現與顯存開銷。
多模態特徵融合 · 成像質量 · 黃斑中心凹定位
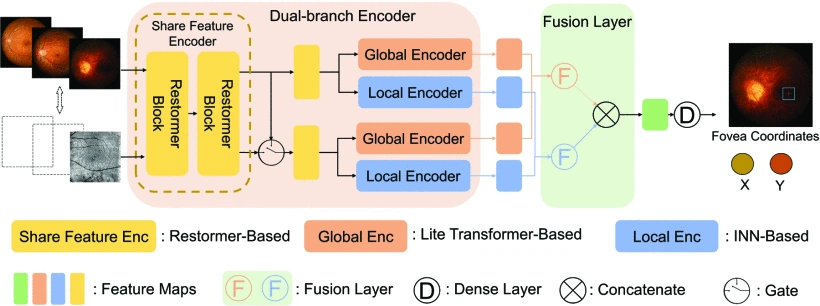
該研究考察在聯合 OCT 與眼底照定位黃斑中心時,OCT 質量與樣本數量分別起到什麼作用。模型融合眼底全局上下文與黃斑局部特徵,並在 GAMMA 上分析訓練時缺失 OCT 對定位的影響。
個性化聯邦學習 · 相似度感知蒸餾 · 異構弱標註
pFedWSD 先通過循環蒸餾積累各站點的共性知識,再以批歸一化統計量估計站點相似度,為各站點構建個性化教師。該框架同時處理機構間的數據分佈差異與稀疏標註形式差異。
採集先驗 · 光聲顯微成像 · Transformer 超分辨率
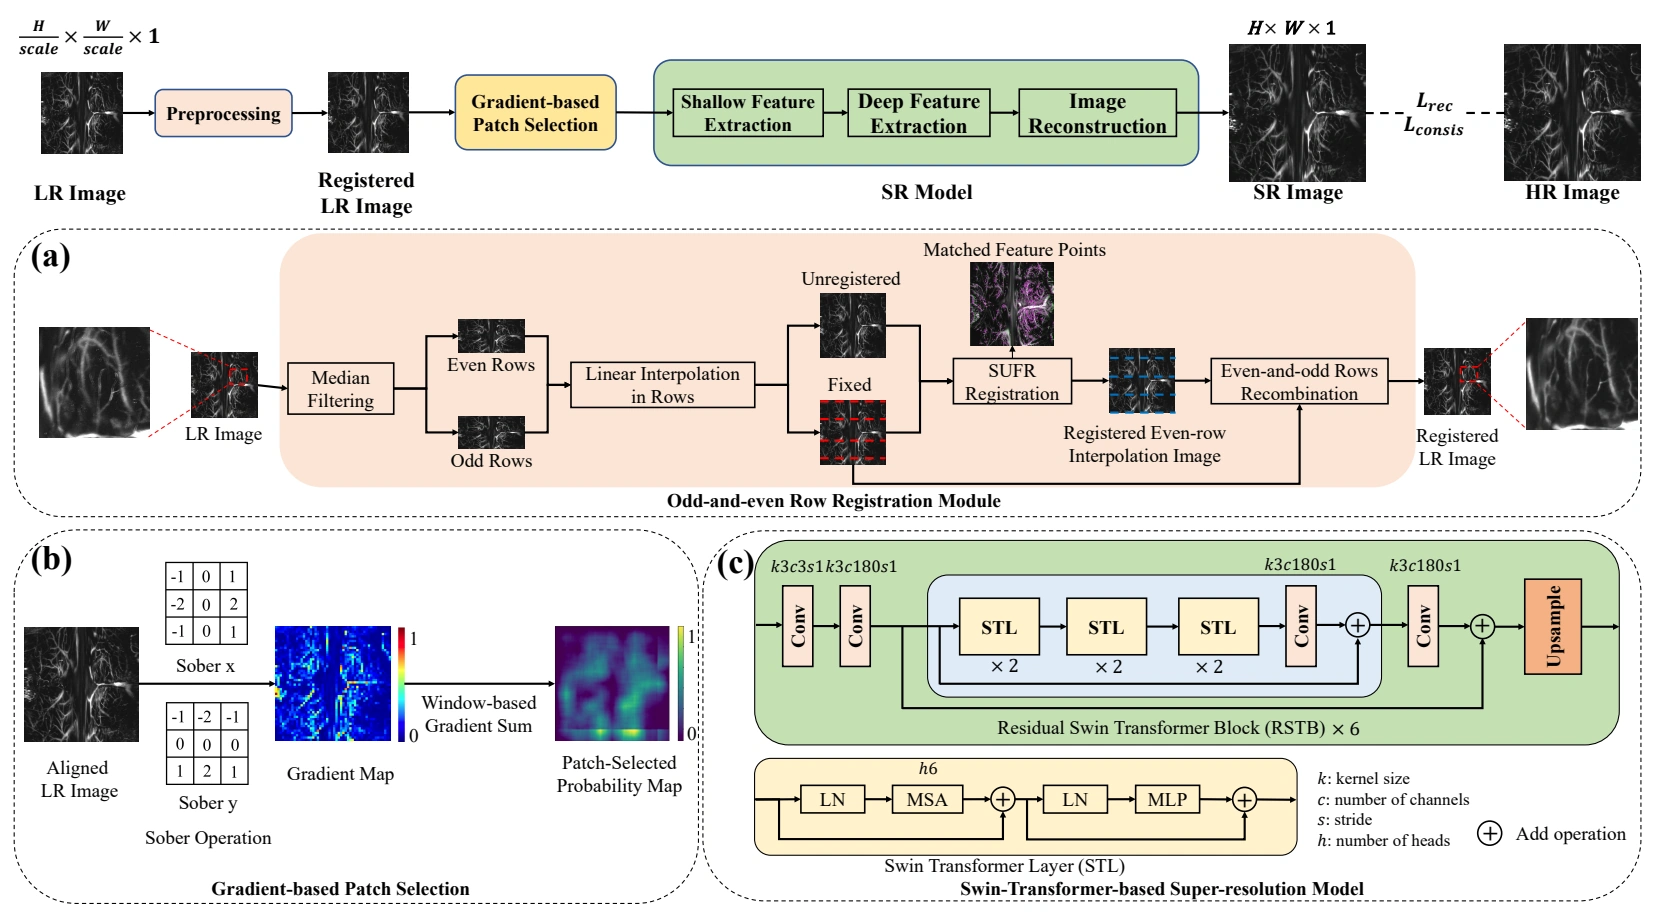
該研究將旋轉採集的掃描機制引入光聲顯微超分辨率重建。重建前先配準奇偶掃描行以校正行間位移,再用包含運動位移的退化與梯度引導的圖塊採樣訓練 Transformer,以恢復精細血管結構。
多模態眼科影像 · 基準數據集 · 青光眼分級
GAMMA 挑戰提供 300 組配對眼底照與 OCT 體數據,並建立統一的多模態青光眼分級評測流程。論文比較了參賽方法如何結合二維攝影與三維掃描中的互補信息。
單骨架監督 · 對比圖像合成 · 曲線結構分割
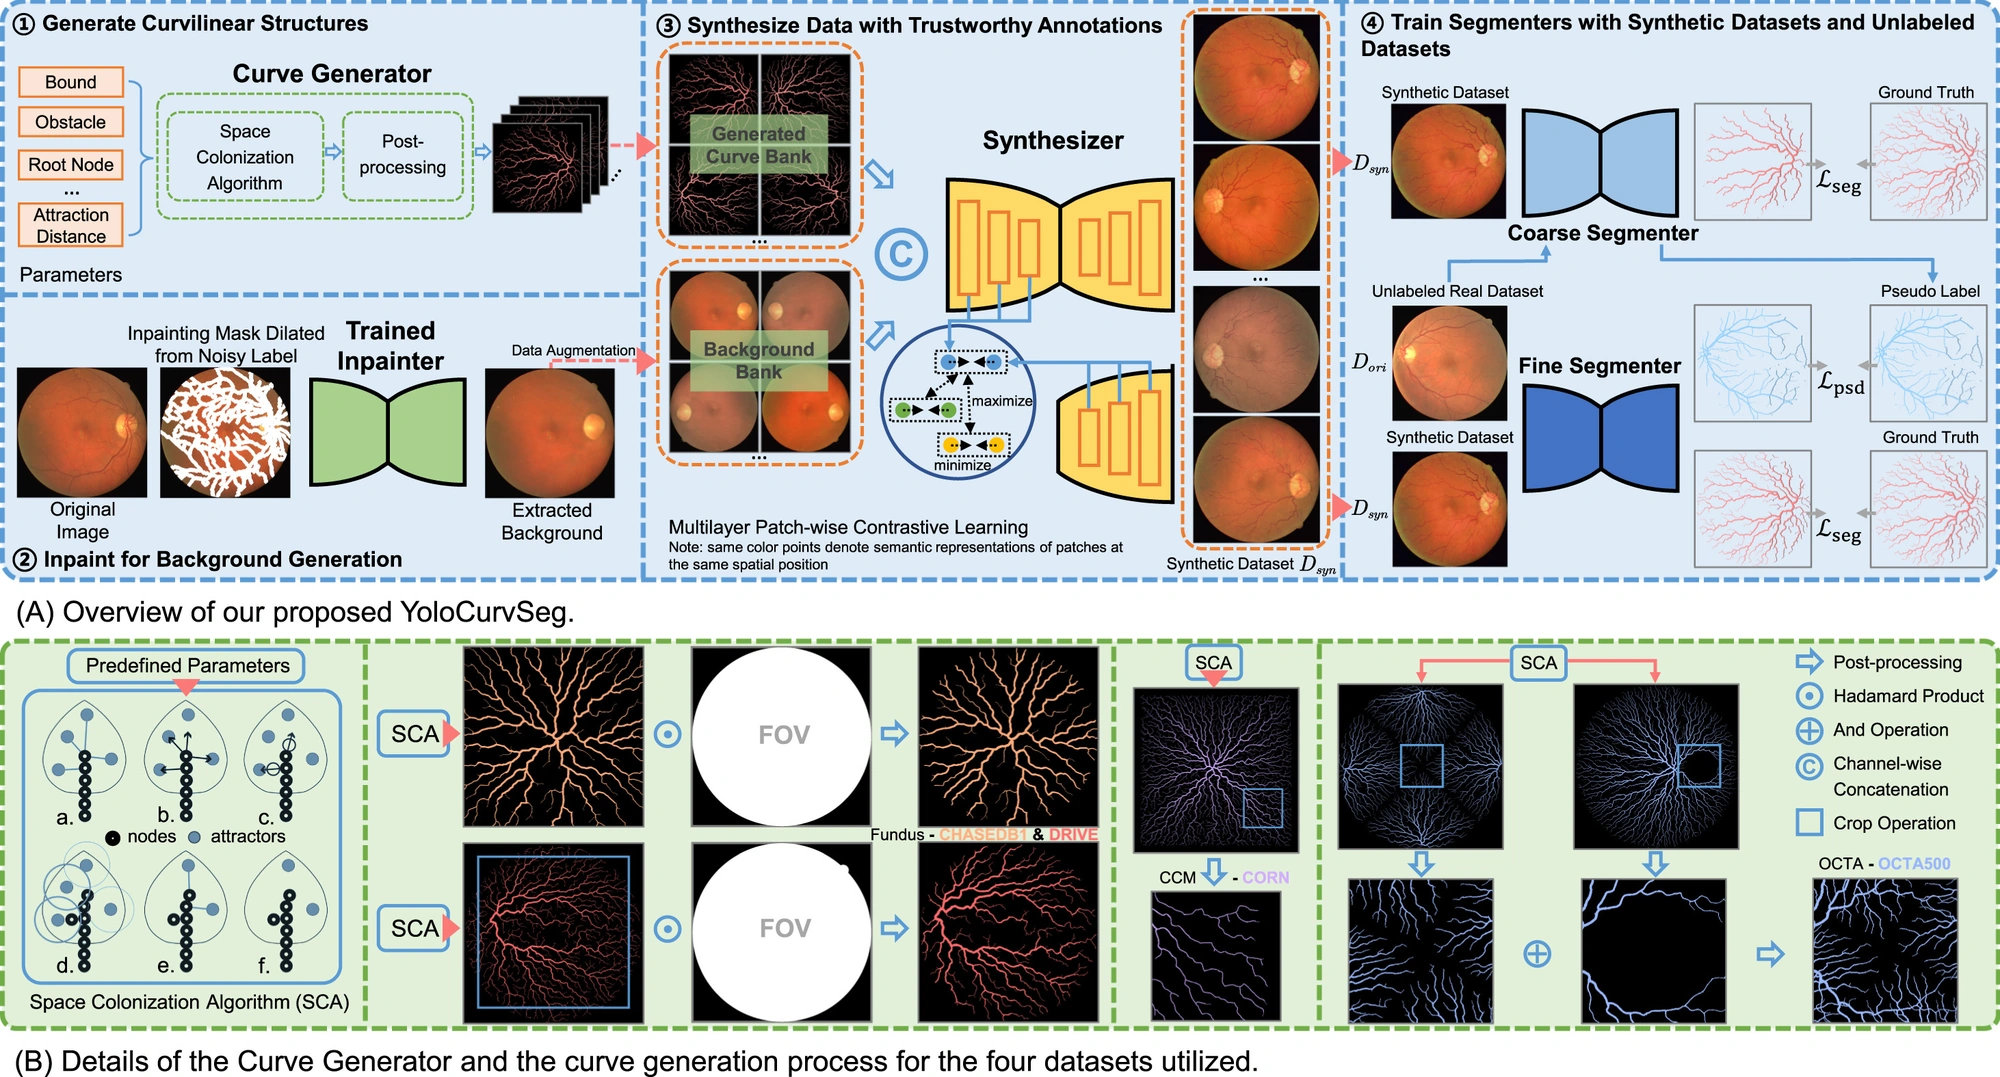
YoloCurvSeg 以一條含噪骨架標註為起點,為血管等曲線結構構造稠密訓練監督。方法利用圖塊級對比學習,將模擬曲線與修復後的影像背景融合成帶掩碼的樣本。以這一標註量訓練的模型在四個公開數據集上均達到相應全監督性能的 97% 以上。
長尾識別 · 課程學習 · 類別級混合增強
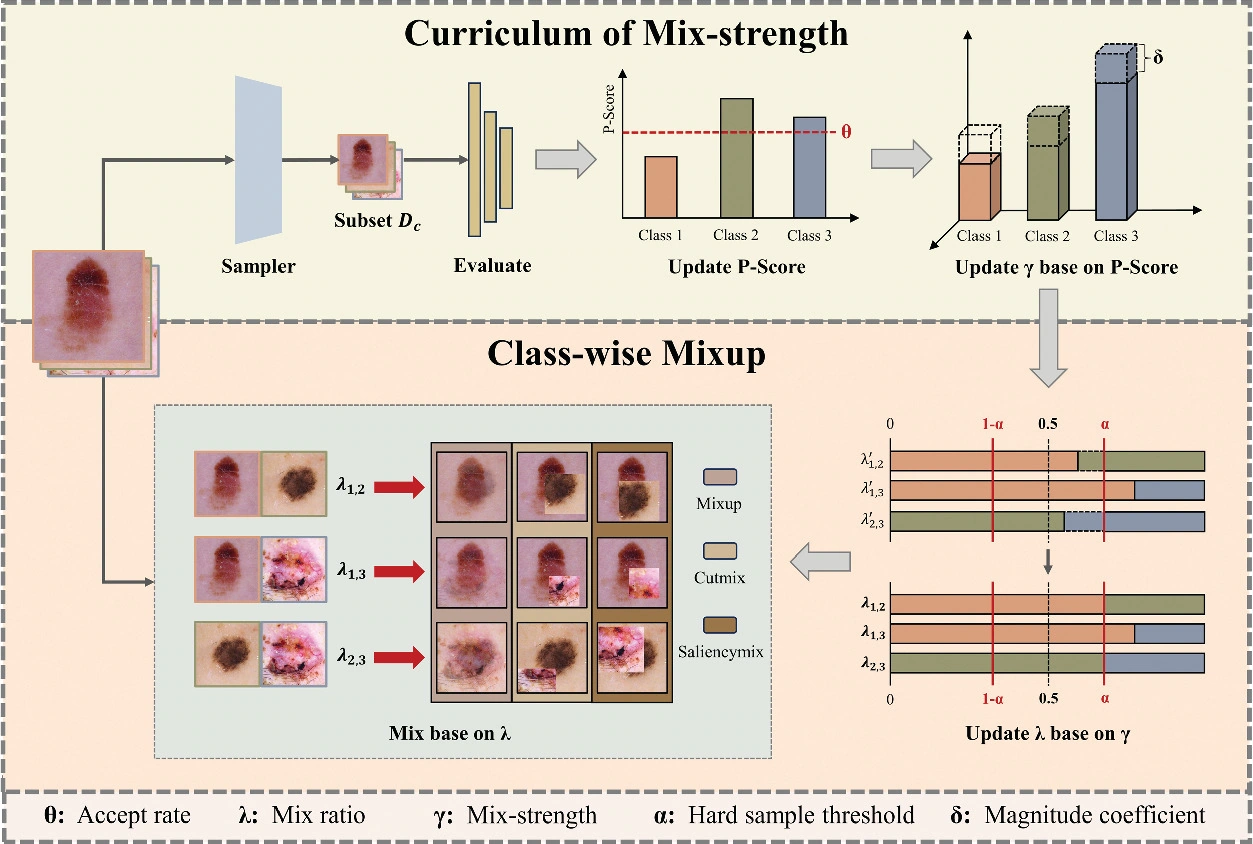
CCMix 在類別層面制定數據增強課程,依據訓練中各類的識別表現調節 Mixup 強度,使少數類樣本按學習難度吸收其他類別的信息。
多專家蒸餾 · 解耦知識遷移 · 長尾識別
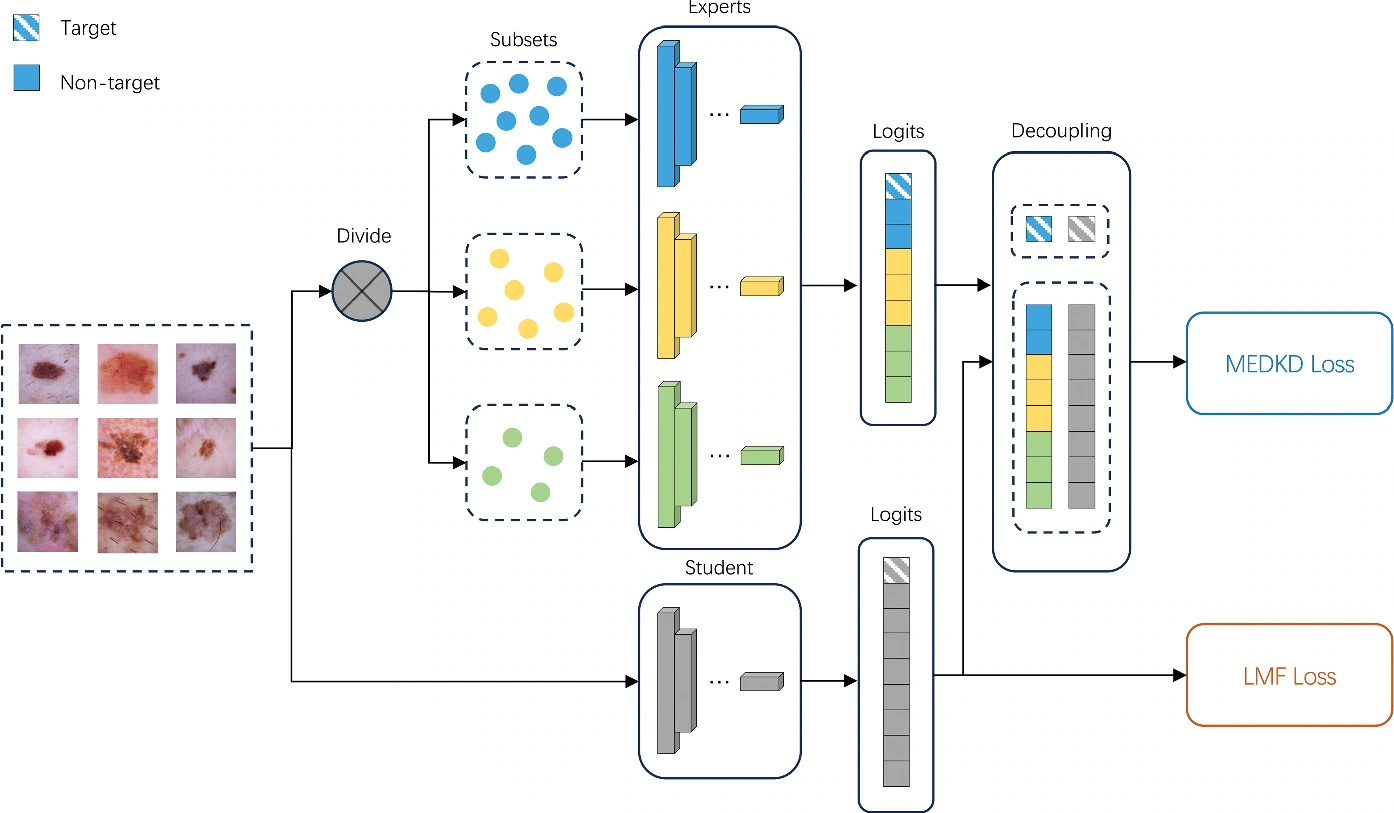
MEDKD 將分別在不同數據子集上訓練的多個專家模型蒸餾至單一分類器。蒸餾目標分開處理目標類與非目標類概率,使長尾分類器能夠利用兩類互補的教師信號。
個性化聯邦學習 · 站點對比表徵學習 · 自適應聚合
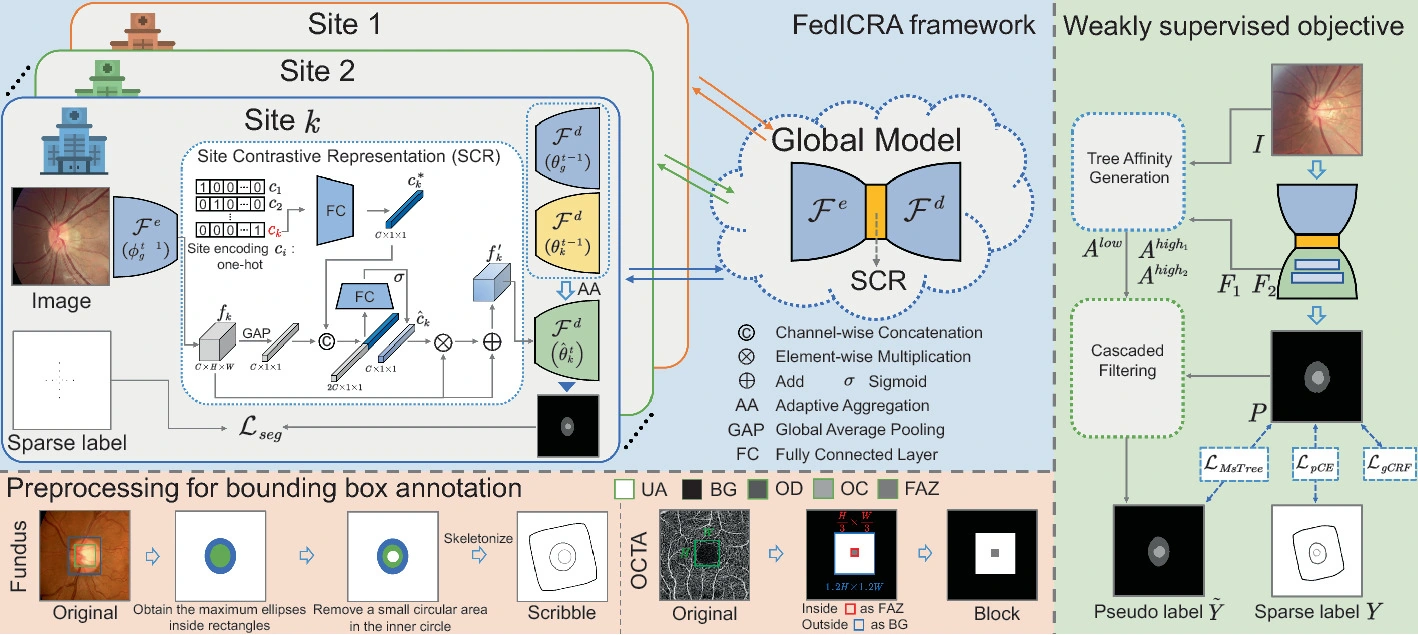
FedICRA 面向採用不同稀疏標註、影像分佈也不同的機構開展個性化聯邦分割。它在選定通道上進行站點對比學習,以區分機構特異表徵,再逐元素融合本地參數與全局共享知識。
醫學圖文預訓練 · 原型學習 · 局部與全局對齊
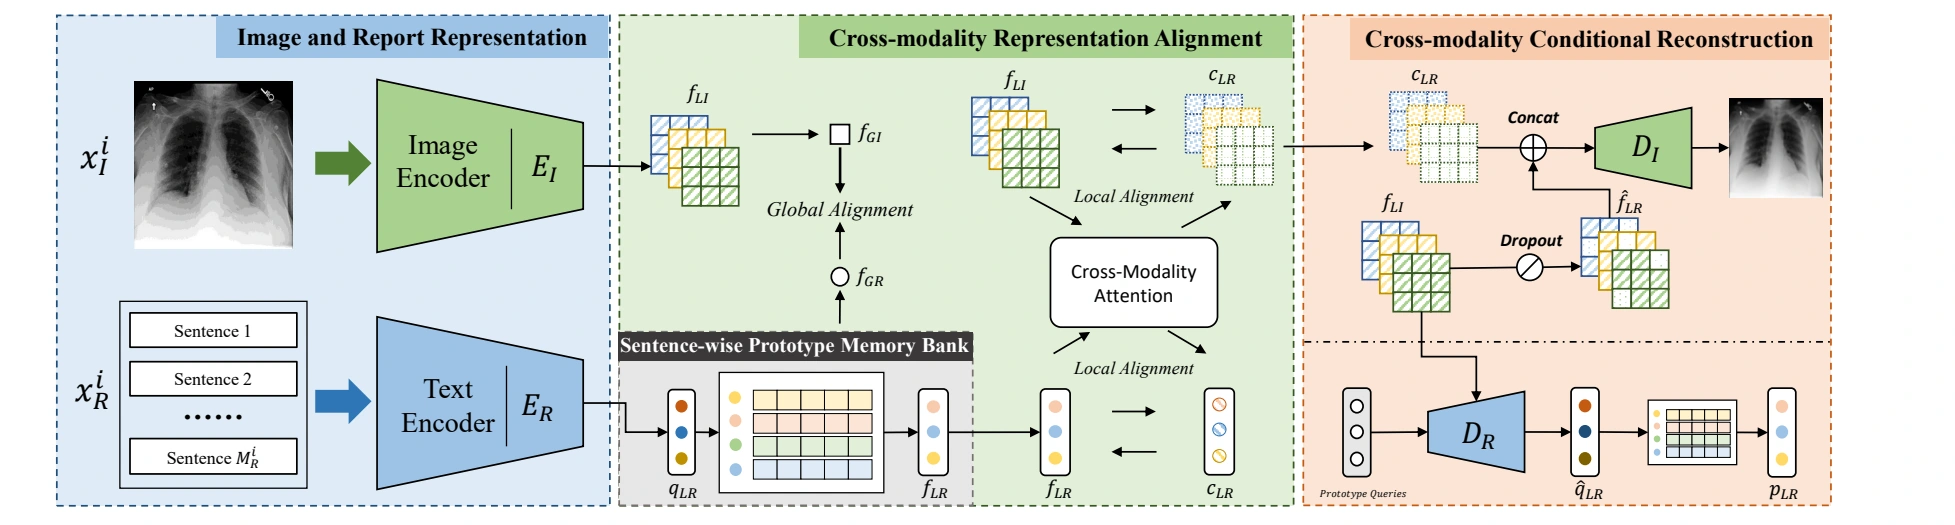
PRIOR 在整幅影像與局部區域兩個尺度對齊醫學圖像和報告,並通過跨模態重建與句子原型庫保留局部成像線索和臨牀語言信息。研究在零樣本分類、圖文檢索與稠密預測等五項任務上檢驗表徵的遷移能力。
對照消融 · 跨數據集泛化 · 糖尿病視網膜病變分級
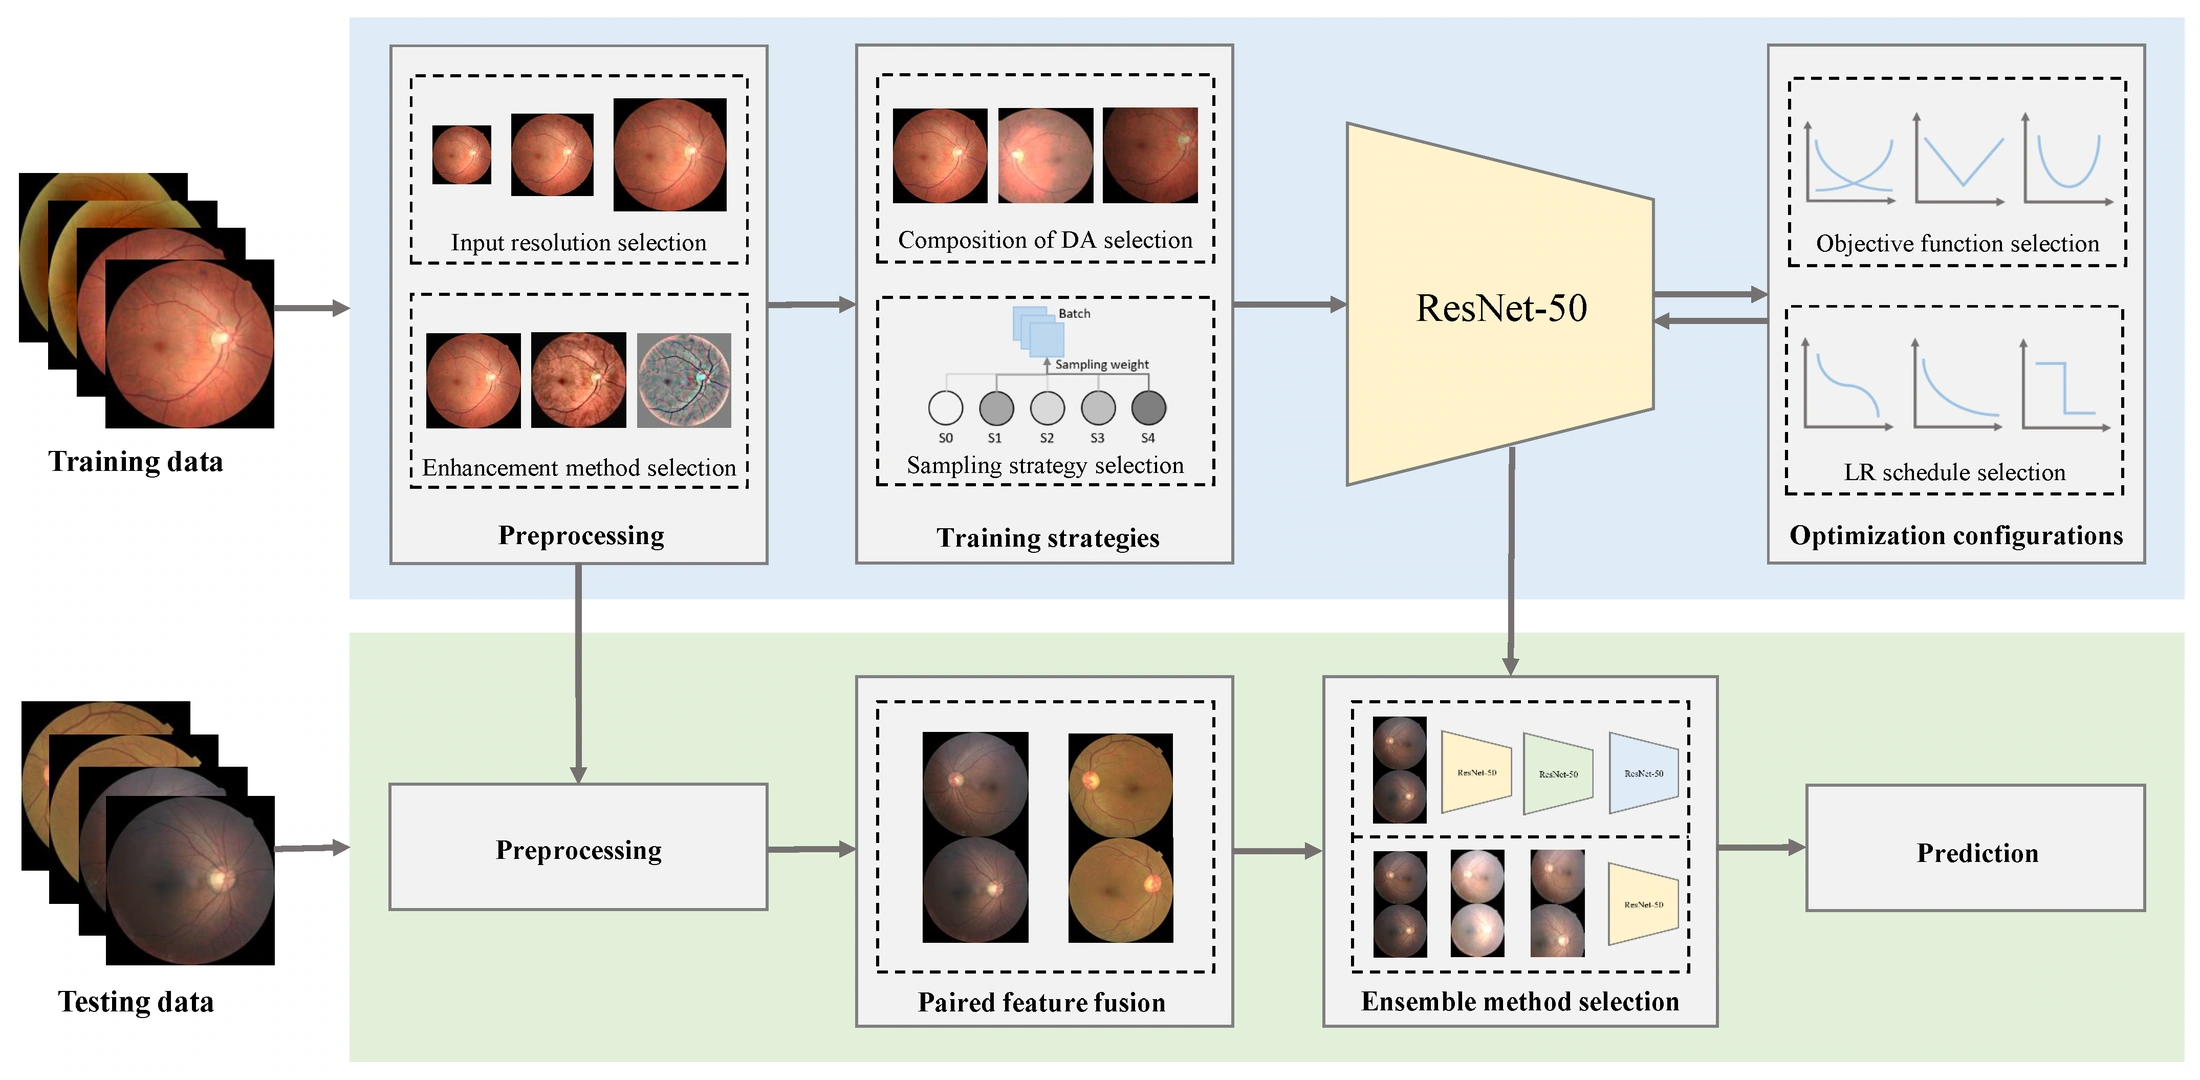
該研究以 ResNet-50 為固定框架,系統考察輸入分辨率、損失函數、增強策略和雙眼配對對糖尿病視網膜病變分級的作用。組合配置在 EyePACS 上的二次加權 Kappa 為 0.8631,並在其他數據集和網絡架構上檢驗了可遷移性。
無監督異常建模 · 測試時聚類 · OCTA 圖像質量評估
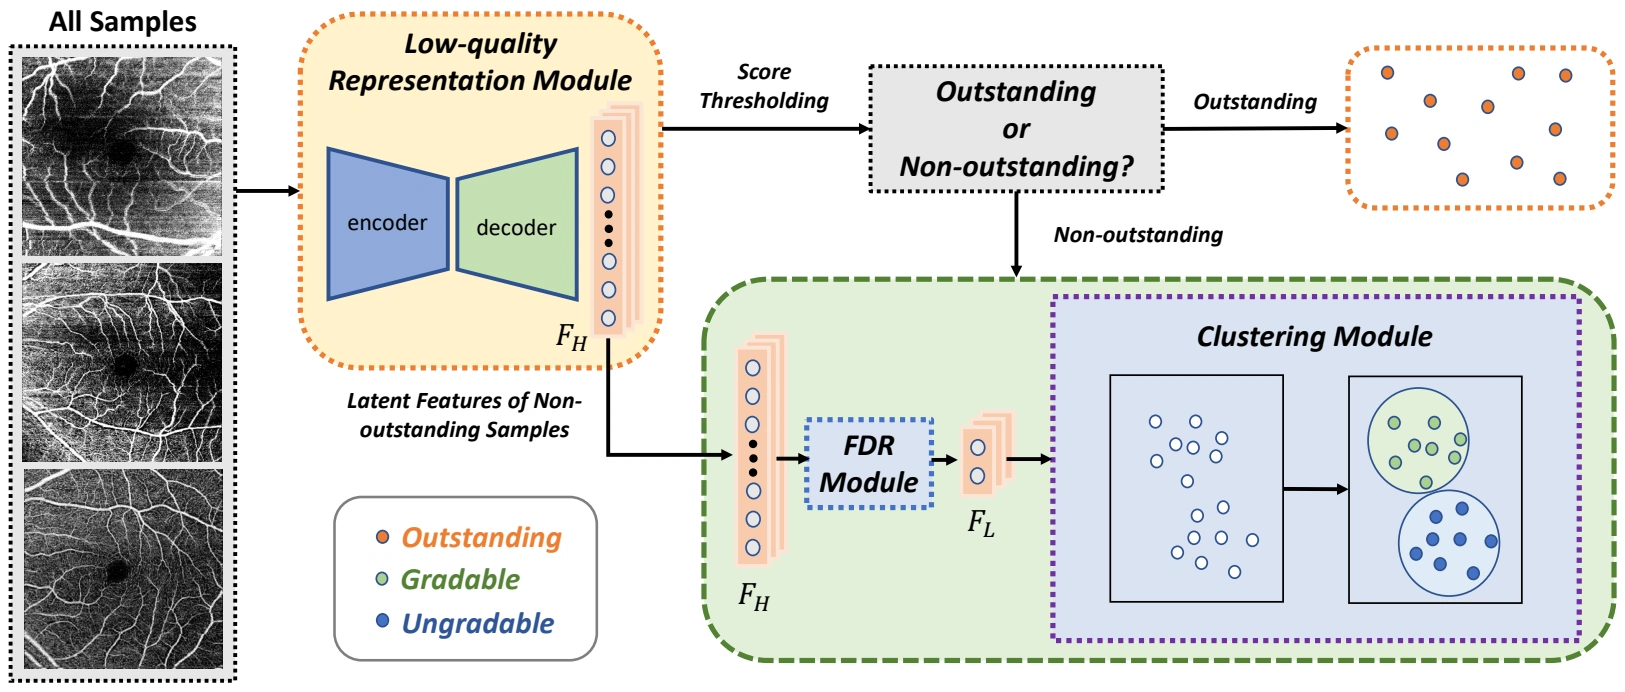
UNO-QA 僅用高質量 OCT 血管成像數據學習異常質量表徵。推理時對多尺度特徵聚類,進一步區分質量較差但仍可判讀的影像與無法判讀的影像。
退化建模 · 條件擴散 · 眼底圖像增強
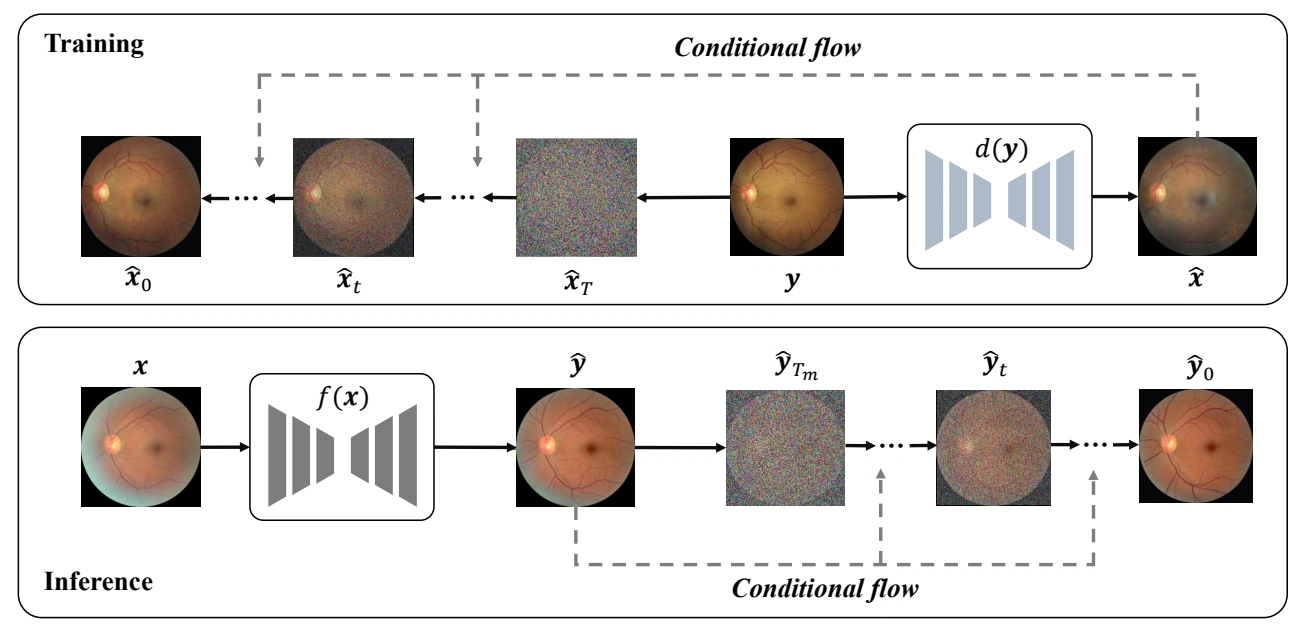
LED 將眼底影像增強建模為已學習退化過程的逆問題。它先從未配對影像中學習質量退化,再用合成配對樣本訓練條件擴散模型,並通過下游分析評估關鍵診斷結構的保留情況。
多目標域適配 · 雙教師蒸餾 · 視網膜血管分割
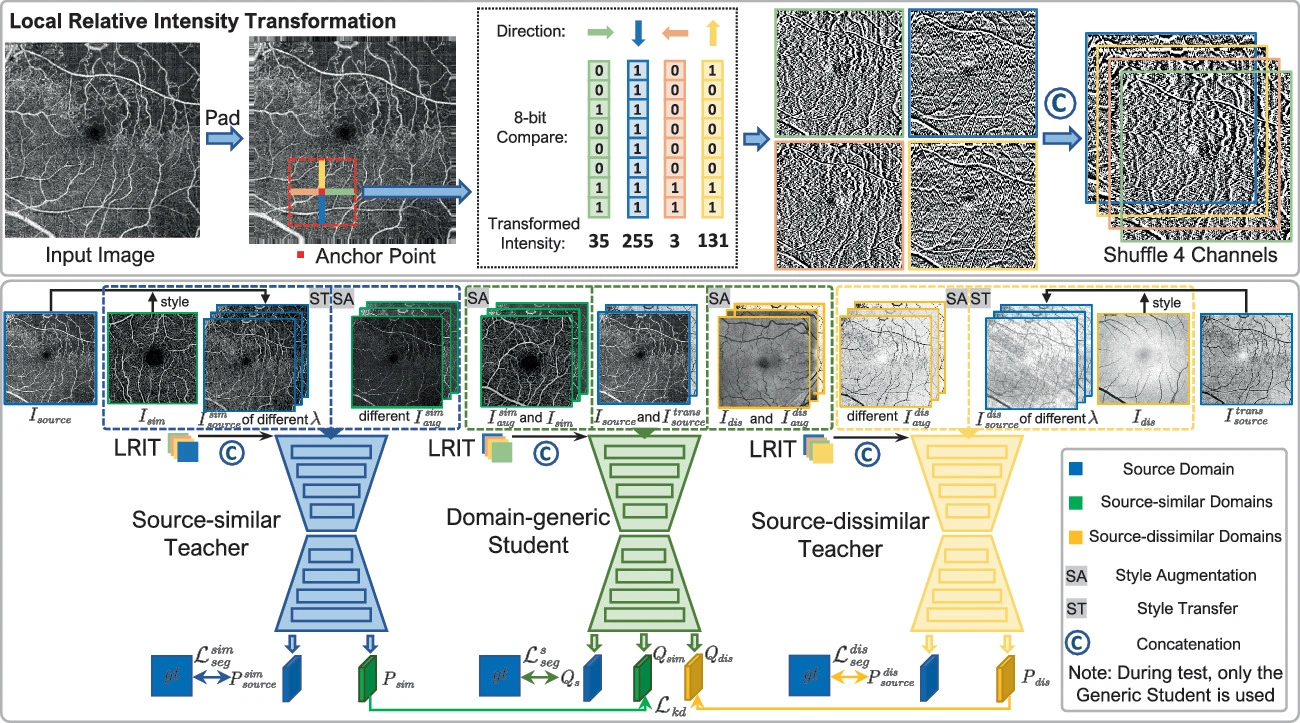
RVms 分別為外觀接近與遠離標註源域的數據訓練教師,再將互補的域知識蒸餾至同一個血管分割器。風格增強與局部相對強度編碼幫助模型適配跨機構、跨模態的多個無標註目標域。
解剖先驗 · 解剖標誌點定位 · 多任務分割
JOINED 以像素到解剖標誌的距離作為輔助監督,聯合完成視盤、視杯分割與黃斑中心定位。模型先用粗分割掩碼和定位熱圖確定感興趣區域,再進行局部精細預測。
域泛化 · 數據增強策略搜尋 · 最優傳輸
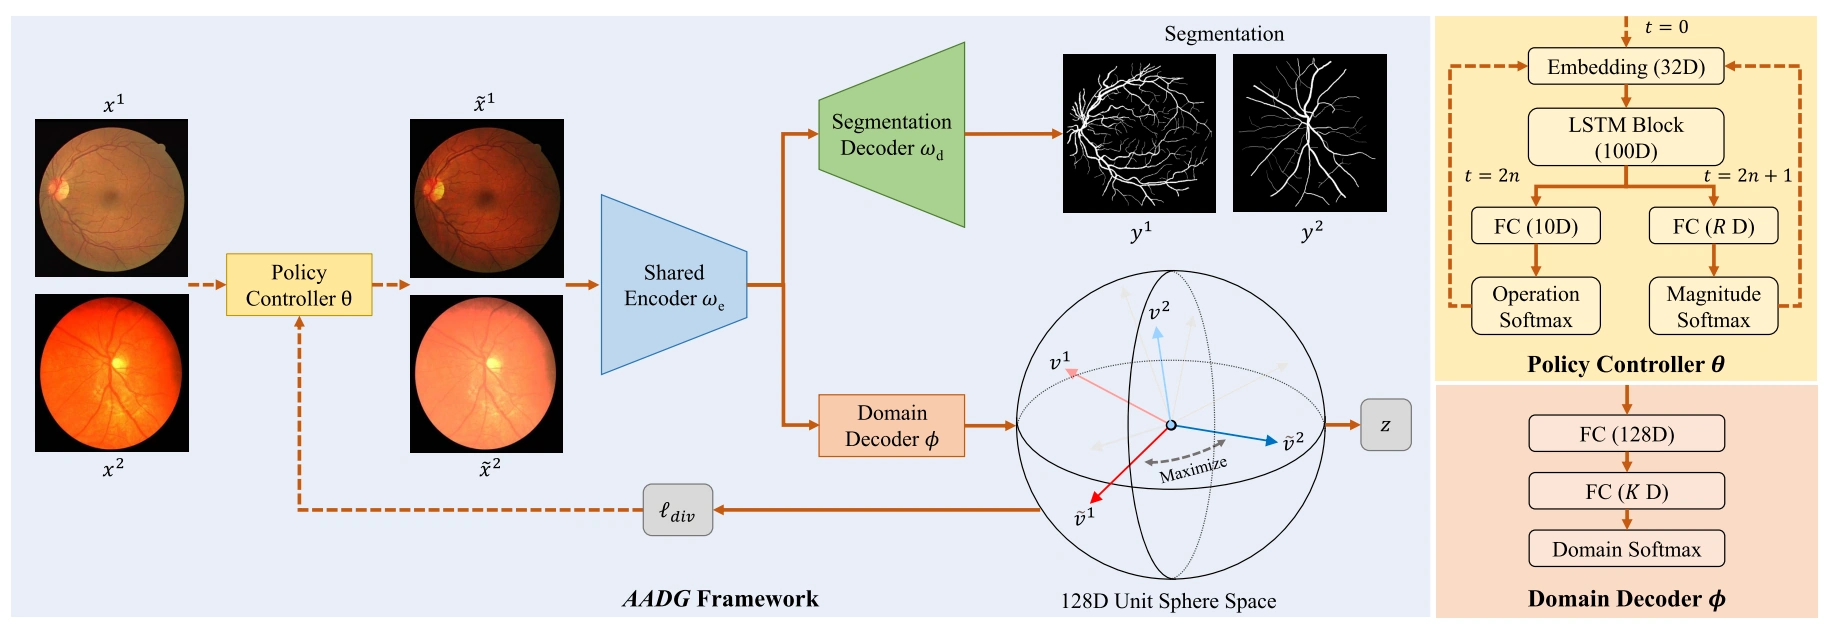
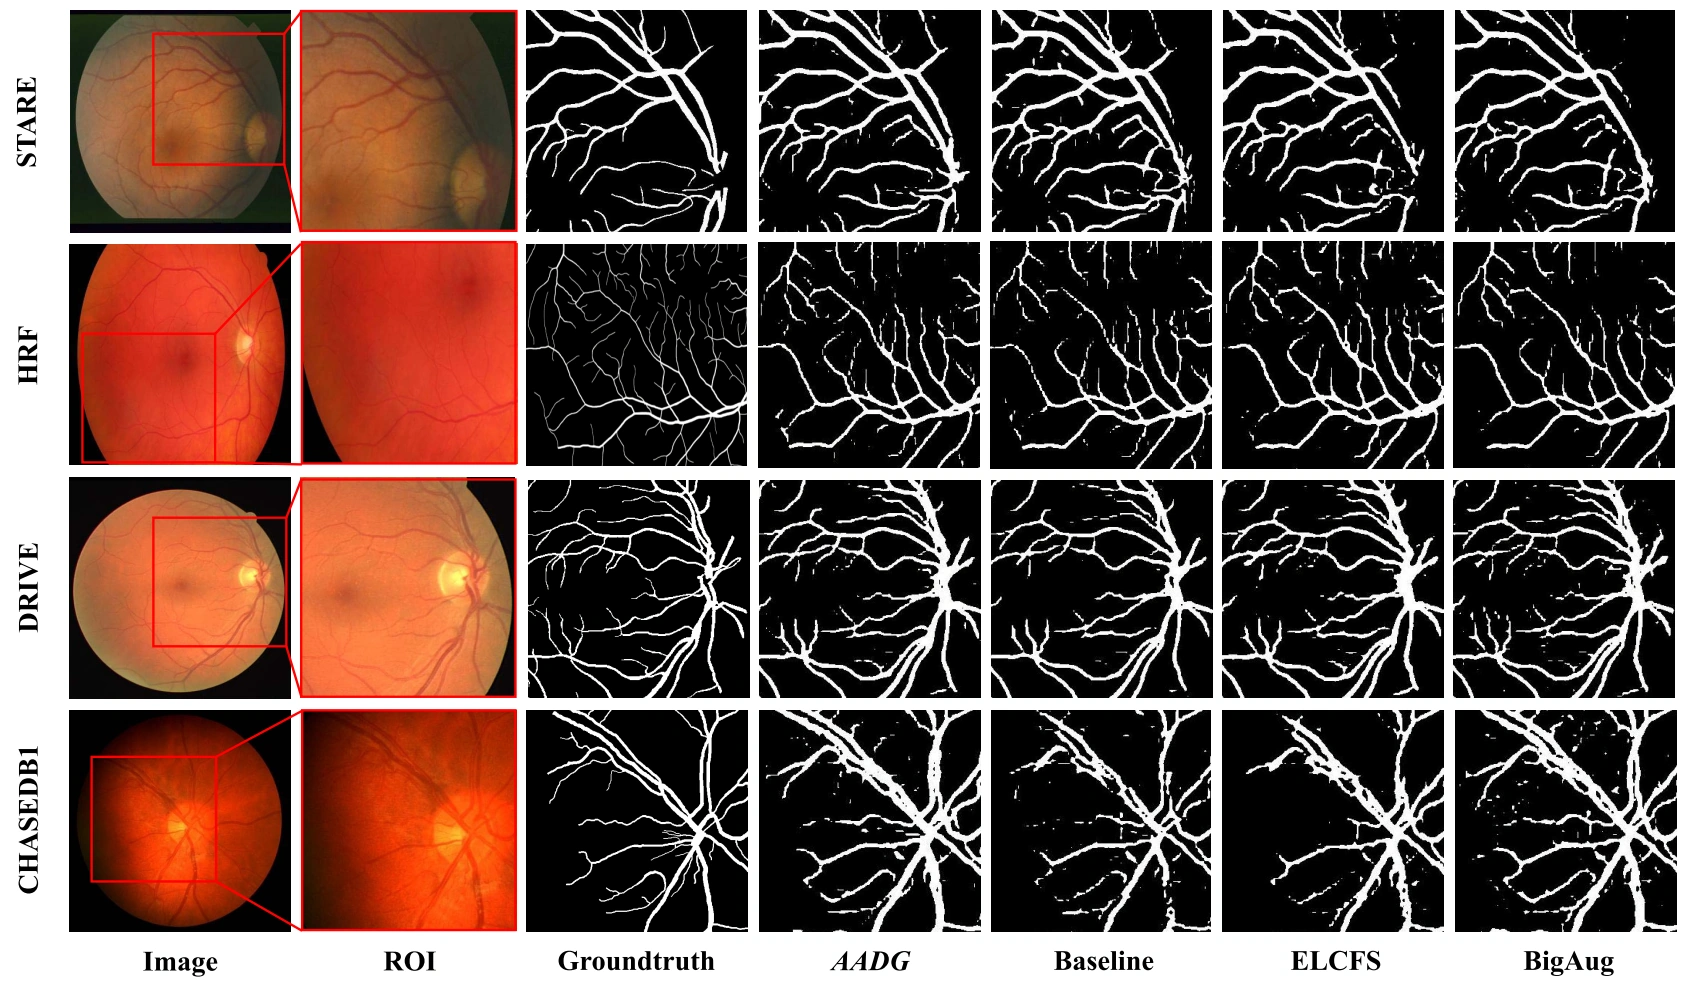
AADG 以特徵空間中增強訓練域之間的 Sinkhorn 距離衡量域多樣性,並自動搜尋數據增強策略。實驗覆蓋 11 個眼底照數據集和兩個 OCT 血管成像數據集,分別檢驗跨數據集與跨模態泛化。
難度感知學習 · 半監督合成 · 對比增強磁共振成像
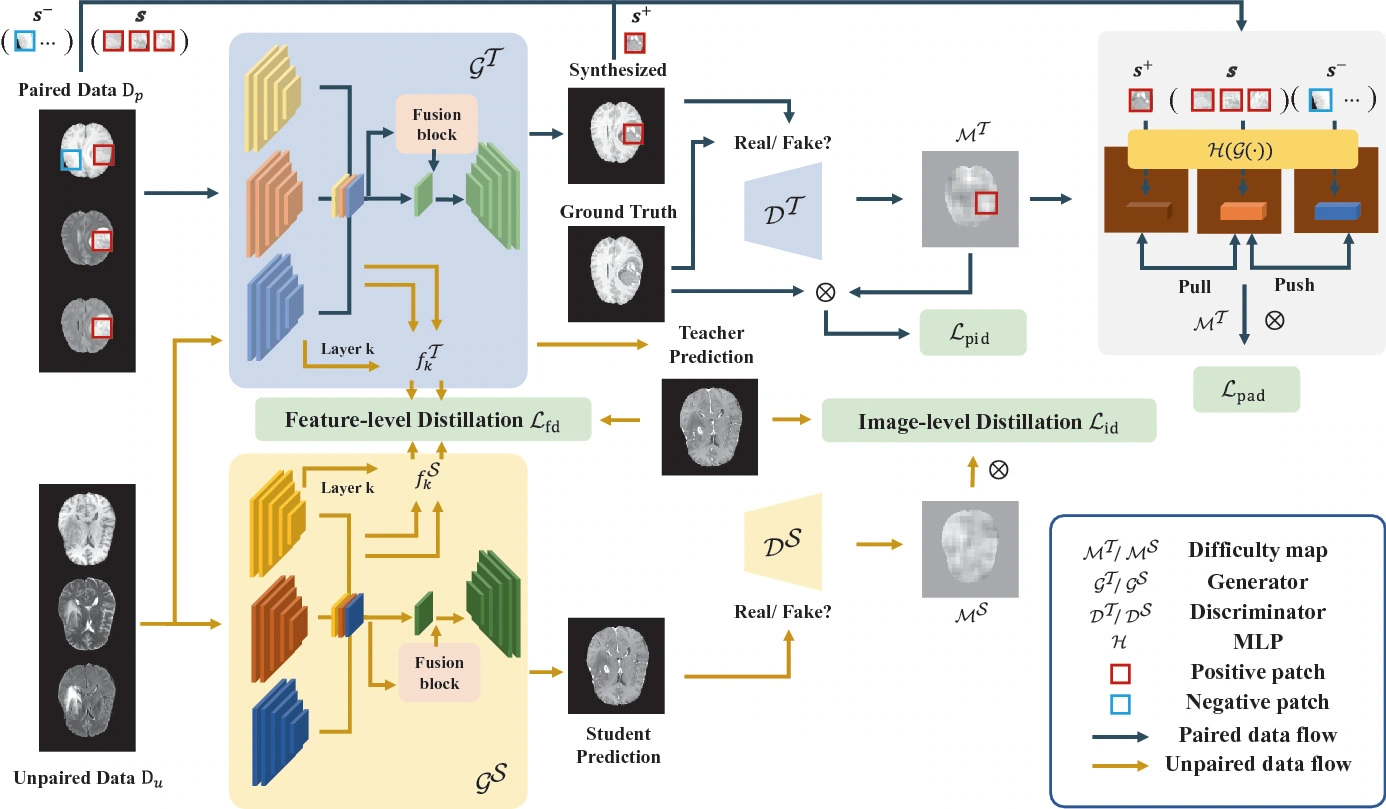
DS³-Net 聯合配對與未配對 MRI 合成對比增強 T1 序列,並用預測的難度圖將像素級約束與圖塊級對比學習聚焦於難重建區域。在 BraTS 2020 上,僅使用 5% 配對數據時,其表現仍可與使用全部配對數據的方法相比。
多模態自監督預訓練 · 掩碼圖像建模 · 眼科影像分類
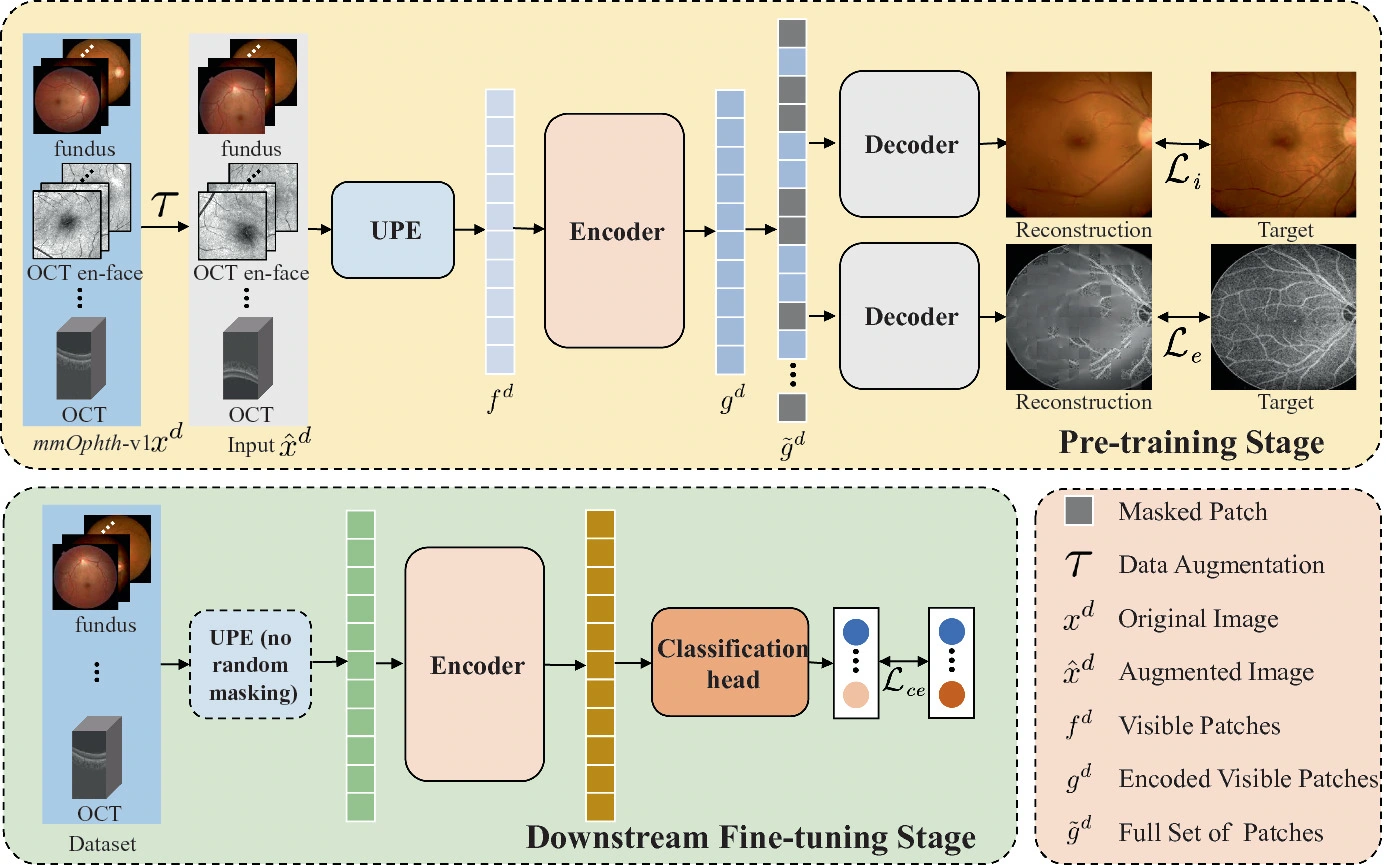
Uni4Eye 通過共享圖塊嵌入,將二維眼科影像與三維體數據納入同一視覺 Transformer 的自監督預訓練。模型聯合重建被遮蓋的圖像強度及其梯度,並在六項分類任務上評估遷移能力。
跨對比度磁共振合成 · Transformer 編碼 · 對抗學習
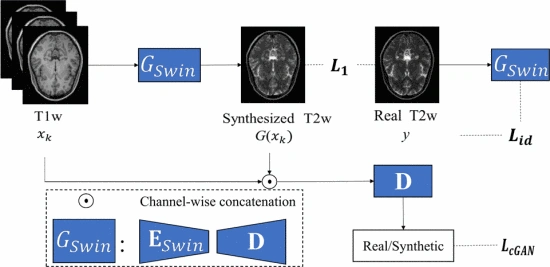
該研究在 T1 到 T2 的條件對抗生成中,用 Transformer 編碼相鄰 T1 切片,為目標切片的合成提供層間上下文,並在公開和內部數據集上評估合成影像的保真度。
監督對比學習 · 眼底影像與 OCT 融合 · 青光眼分級
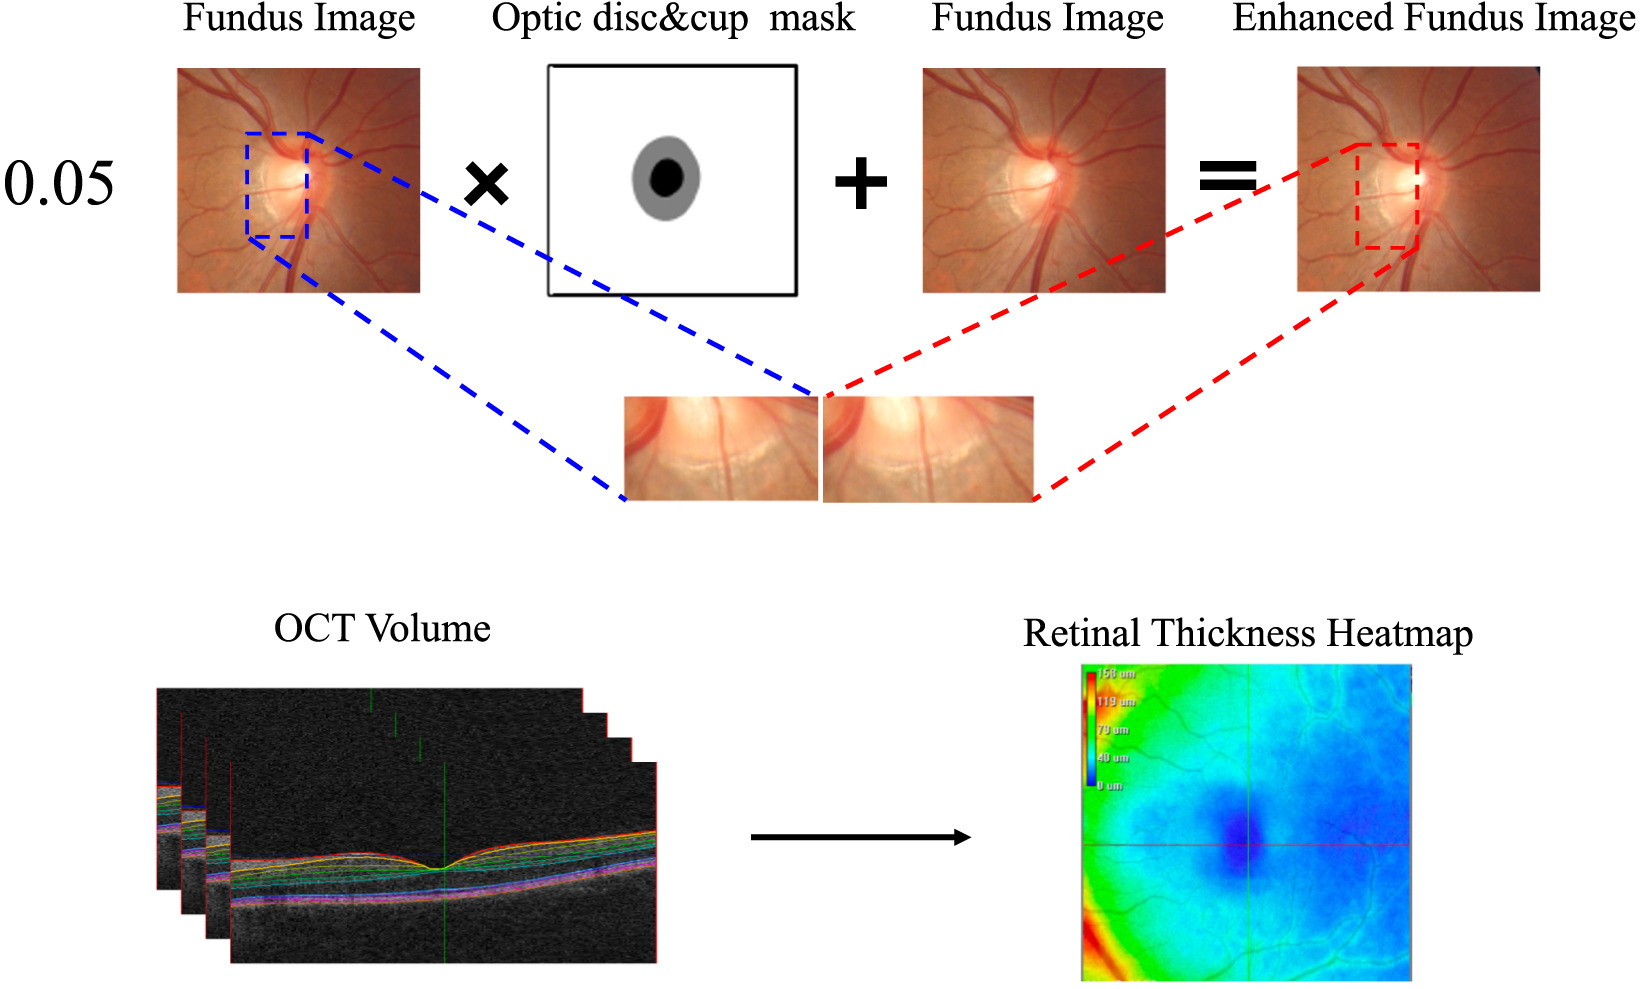
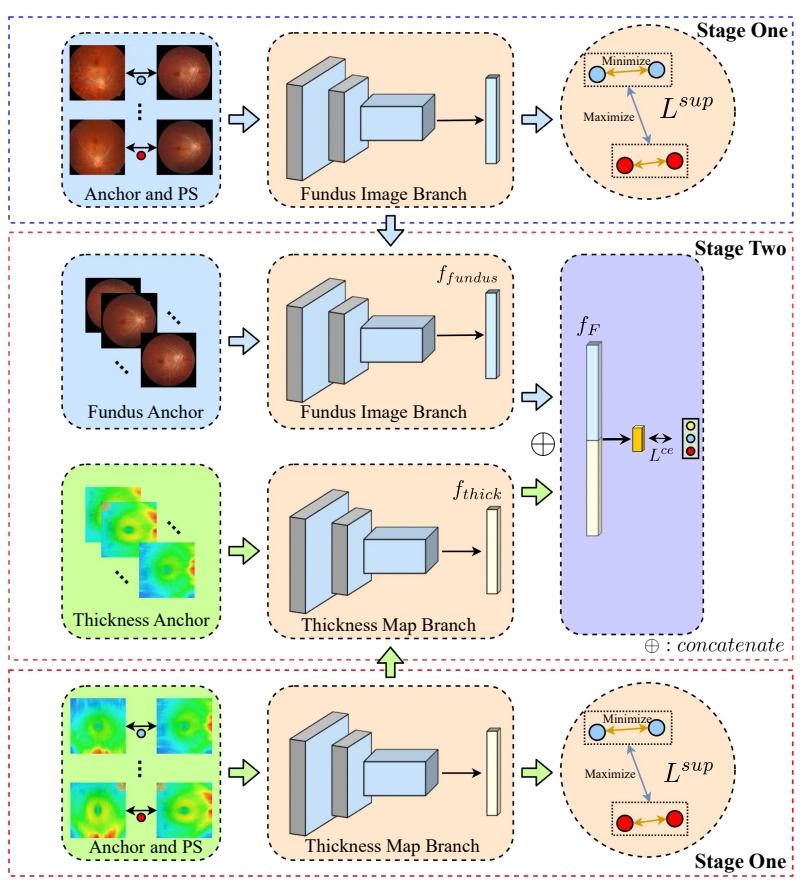
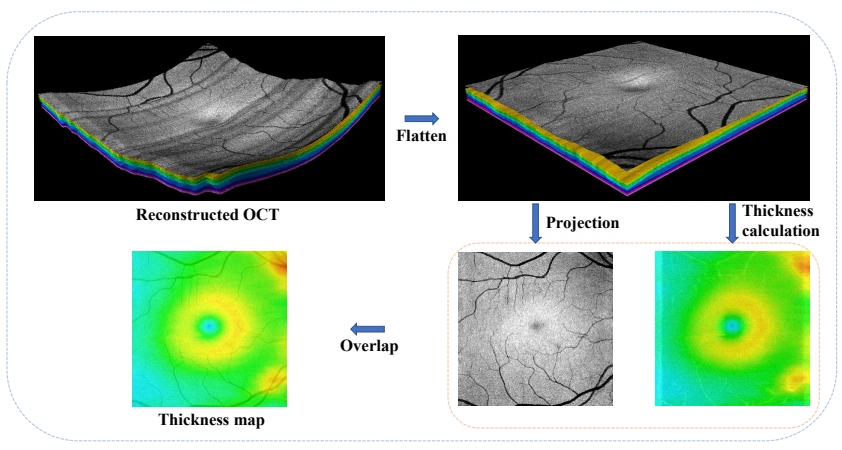
COROLLA 將 OCT 體數據壓縮為視網膜厚度圖,再與彩色眼底特徵進行融合。監督對比學習在表徵空間區分青光眼等級,緊湊的 OCT 表示則降低多模態融合的計算開銷。
無監督域適配 · 解耦風格遷移 · 跨模態分割
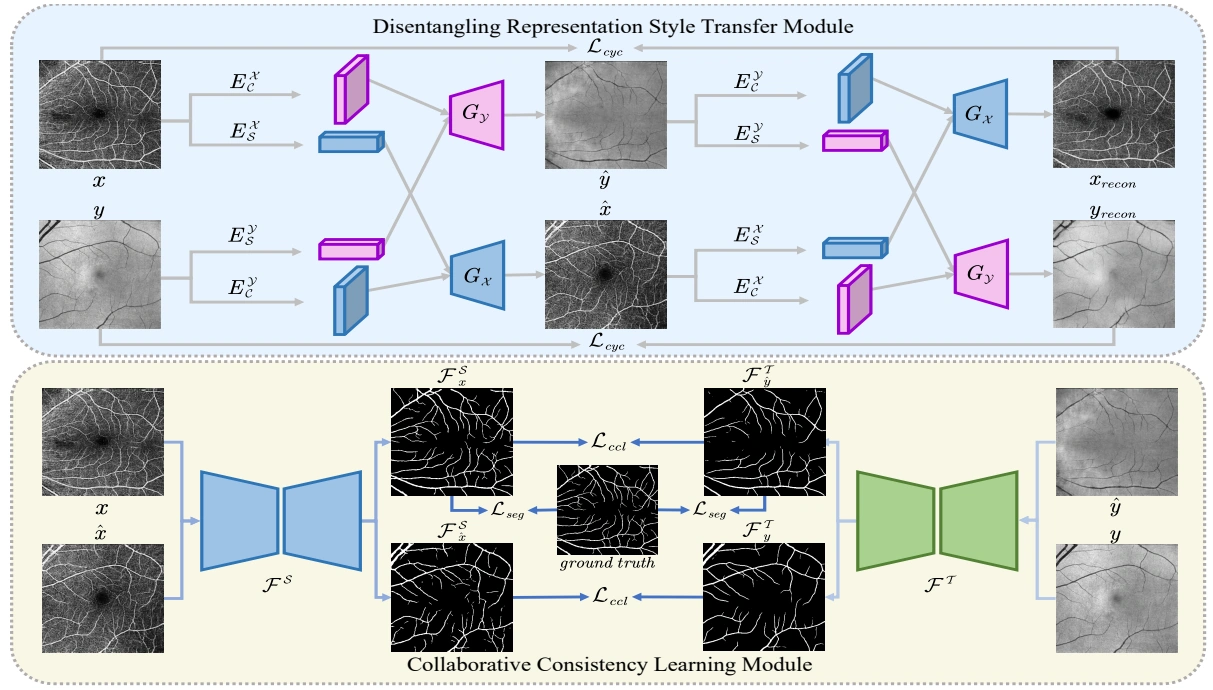
DCDA 在沒有目標域標註的條件下,將視網膜血管分割適配於 OCT 與 OCT 血管成像之間。解耦式風格遷移分離解剖內容與成像外觀,協同一致性約束使源域和目標域分割器能夠利用未標註影像。
缺失模態合成 · 模態級注意力 · 腦腫瘤分割
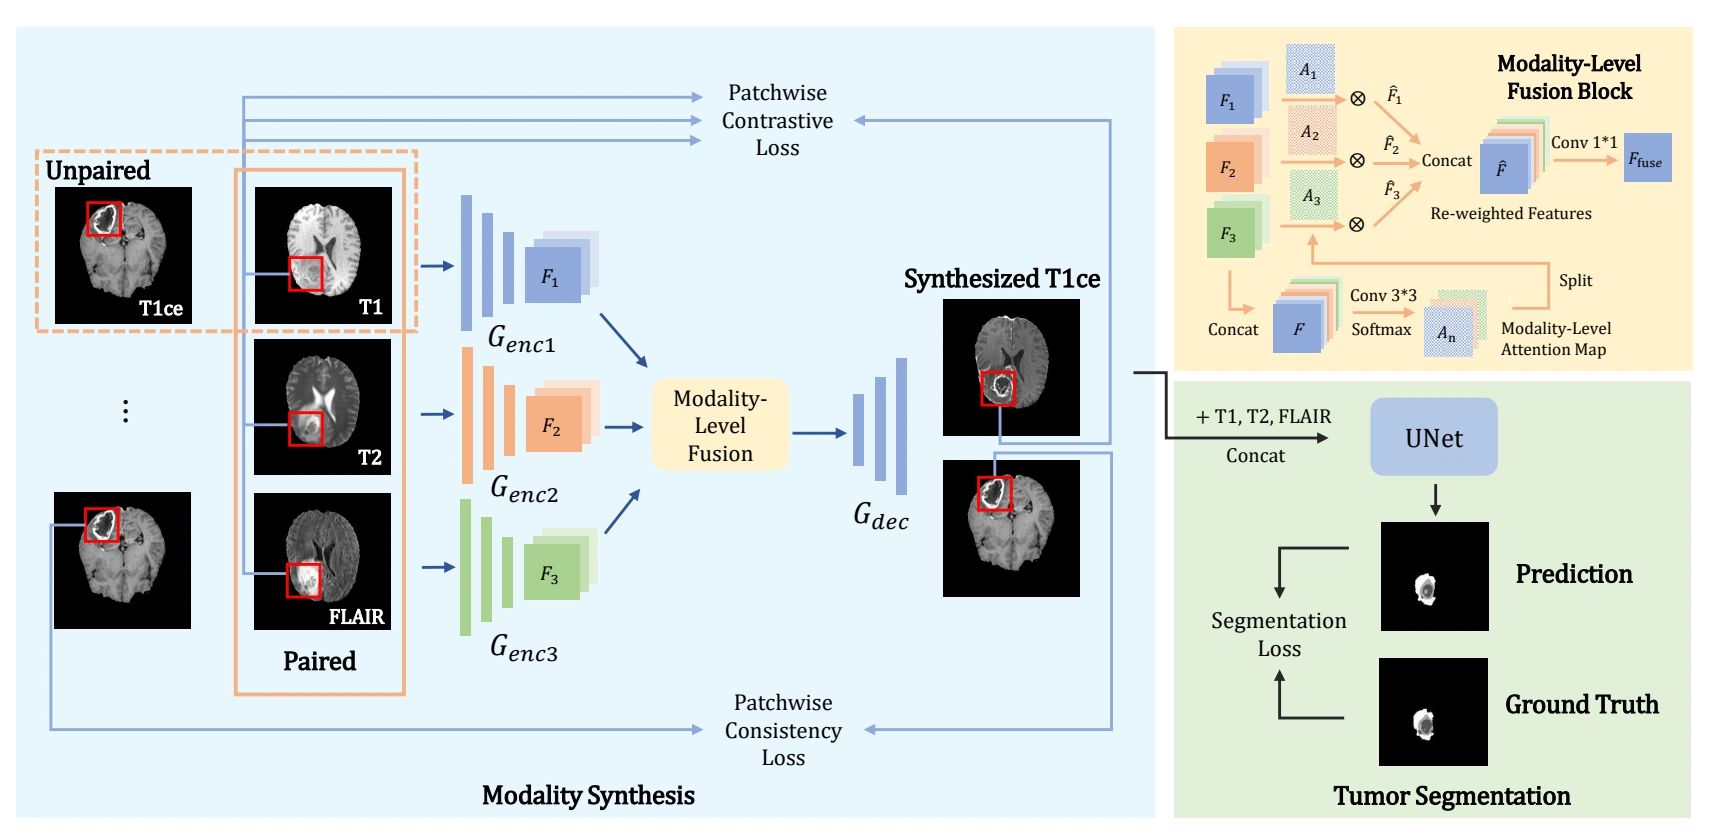
MAF-Net 將常規 MRI 序列到對比增強影像的合成與膠質瘤分割聯合建模。圖塊級對比學習約束潛在表徵,模態級注意力為各序列分配融合權重。預印本在 BraTS 2020 上同時評估了合成和分割。
對抗學習 · 雙重注意力 · 血管拓撲分析
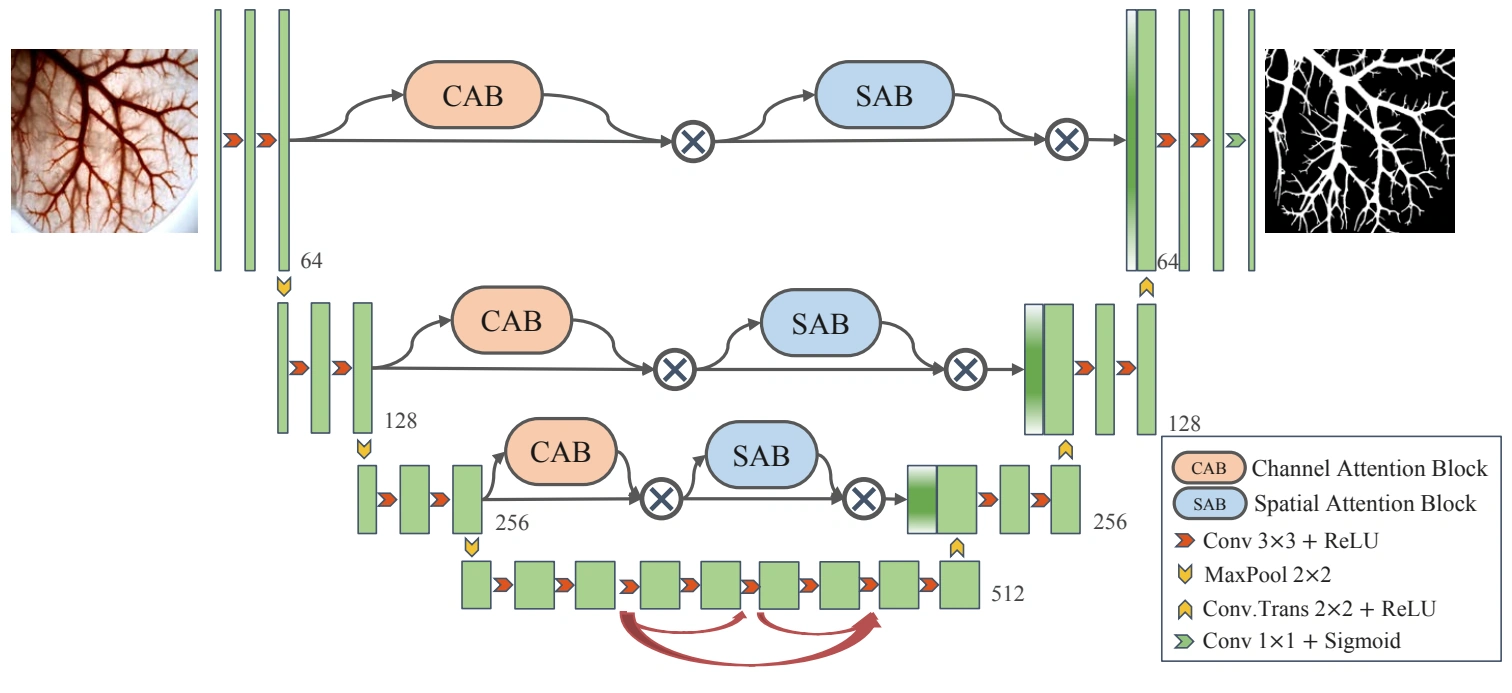
該研究將肝血管分割延伸到定量拓撲分析。採用對抗訓練的雙注意力 U-Net 生成血管掩碼,再對血管骨架計算分支長度與分叉級次。
多任務學習 · 黃斑中心凹無血管區分割 · 光學相干斷層血管成像
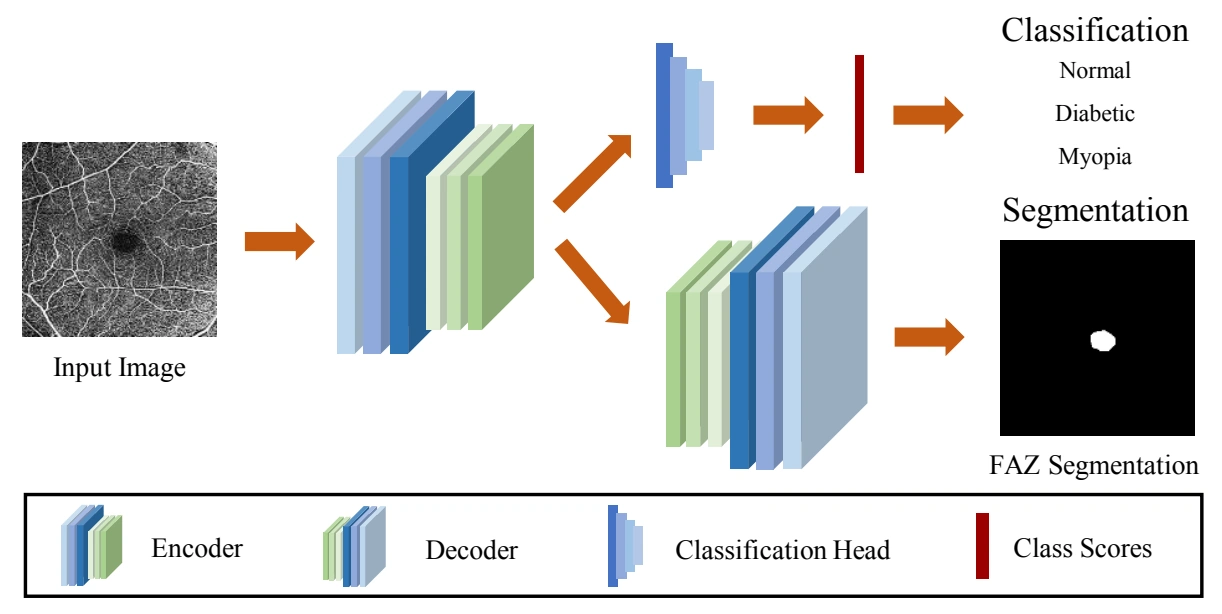
該研究在 OCT 血管成像中共享無血管區分割與三分類的編碼器,並在 FAZID 上檢驗分割獲得的解剖表徵能否輔助區分正常、糖尿病與近視眼。
幾何感知學習 · 聯合分割與分類 · 光學相干斷層血管成像
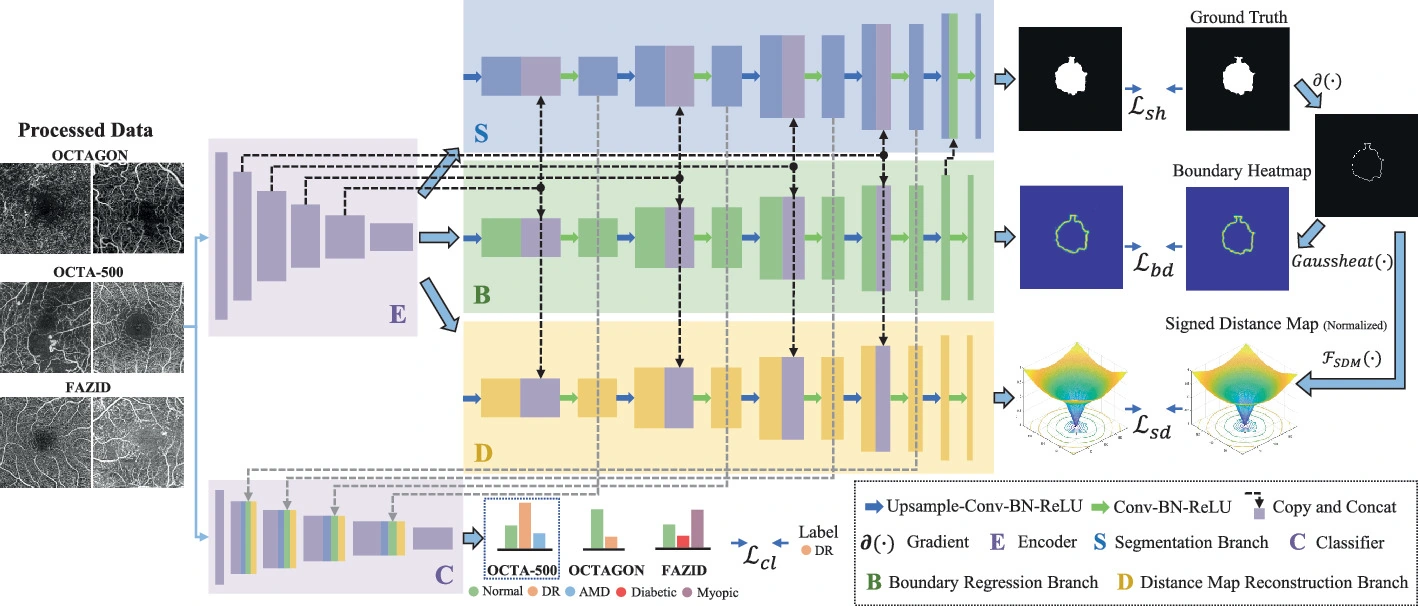
BSDA-Net 在黃斑中心凹無血管區分割之外,聯合迴歸邊界熱圖和重建有符號距離圖,以學習其幾何形態。分層融合將結構表徵傳遞給診斷分類器,使幾何勾畫與疾病判別共享信息。
多任務分割 · 解剖上下文 · 光學相干斷層血管成像
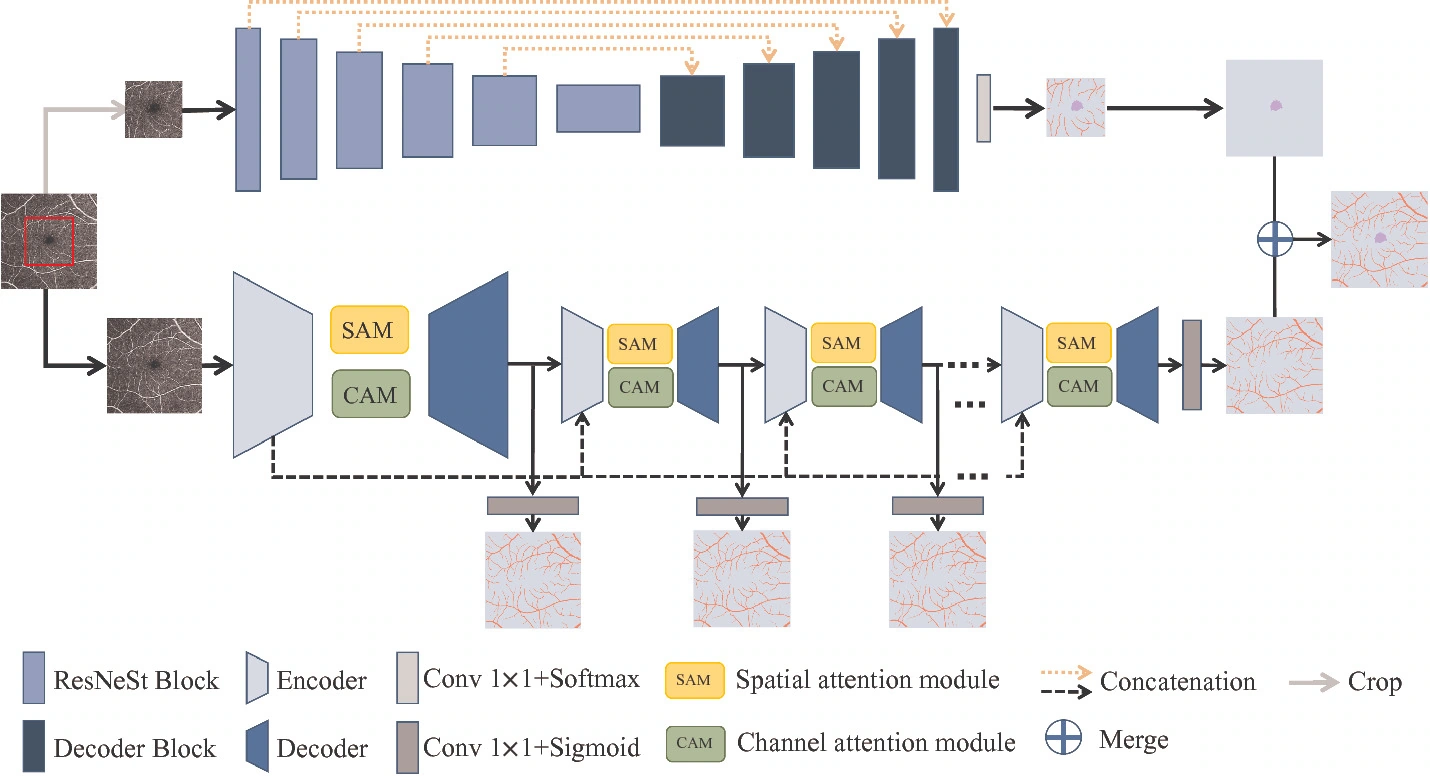
FARGO 在正面投影的 OCT 血管影像中,以視網膜血管作為分割黃斑中心凹無血管區的解剖上下文。獨立的粗到細血管分支利用空間和通道注意力細化細小、低對比度的結構。
半監督學習 · 重要性引導對比學習 · 眼底圖像增強
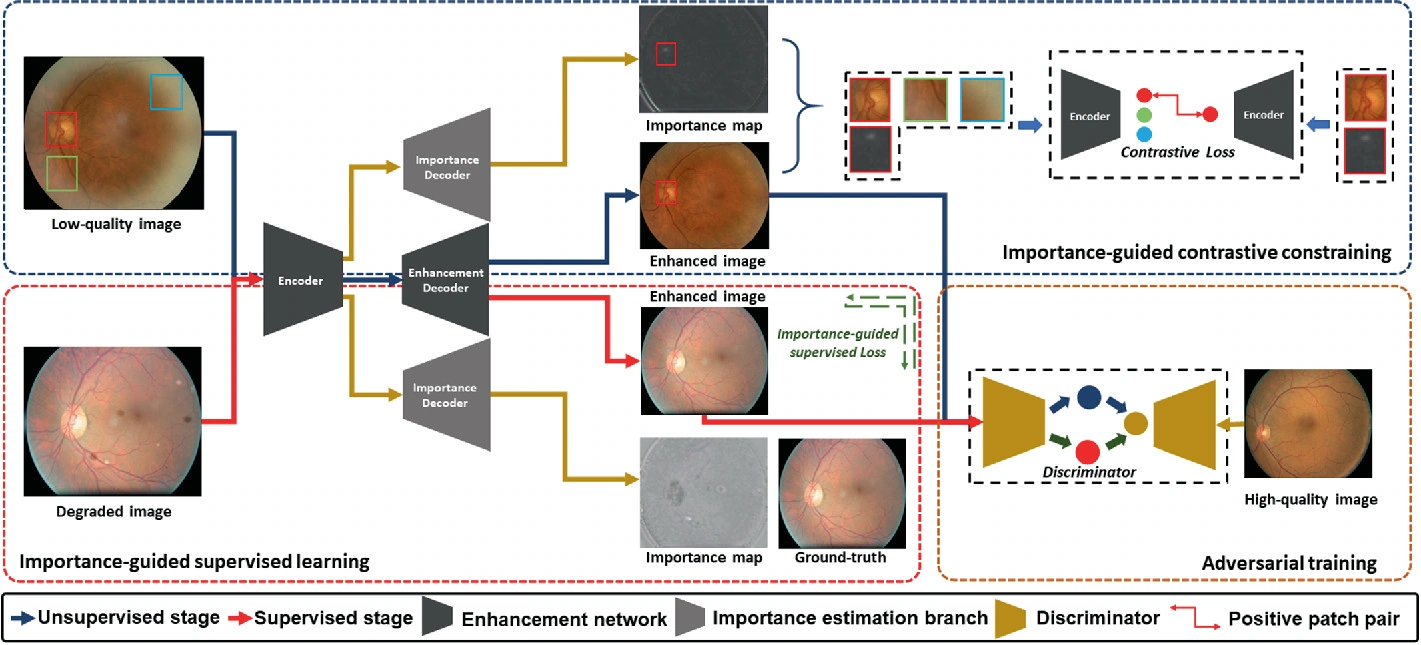
I-SECRET 聯合利用合成退化配對與未配對真實眼底照進行影像增強。像素級重要性估計分別引導兩條分支中的監督重建與對比學習。
自監督對比學習 · 病灶感知表徵 · 糖尿病視網膜病變分級
該研究使用以病灶為中心的圖塊進行自監督對比學習,使表徵對糖尿病視網膜病變分級所需的微小病理信號更敏感,並通過 EyePACS 上的線性評估與遷移實驗檢驗所得特徵。
對比圖像合成 · 共聚焦顯微成像 · 角膜神經分割
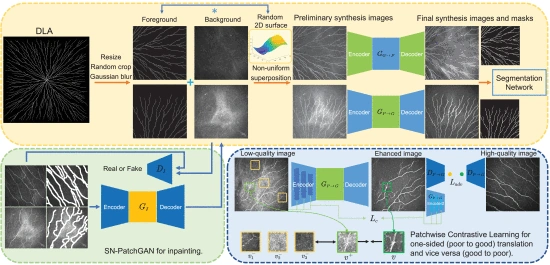
該流程結合影像合成與質量增強,處理角膜共聚焦顯微圖像中的標註誤差與照明不均。多層圖塊對比學習用於構造神經分割訓練樣本,研究在兩個公開數據集上檢驗其效果。
非配對圖像轉換 · 圖塊對比學習 · 眼底圖像增強
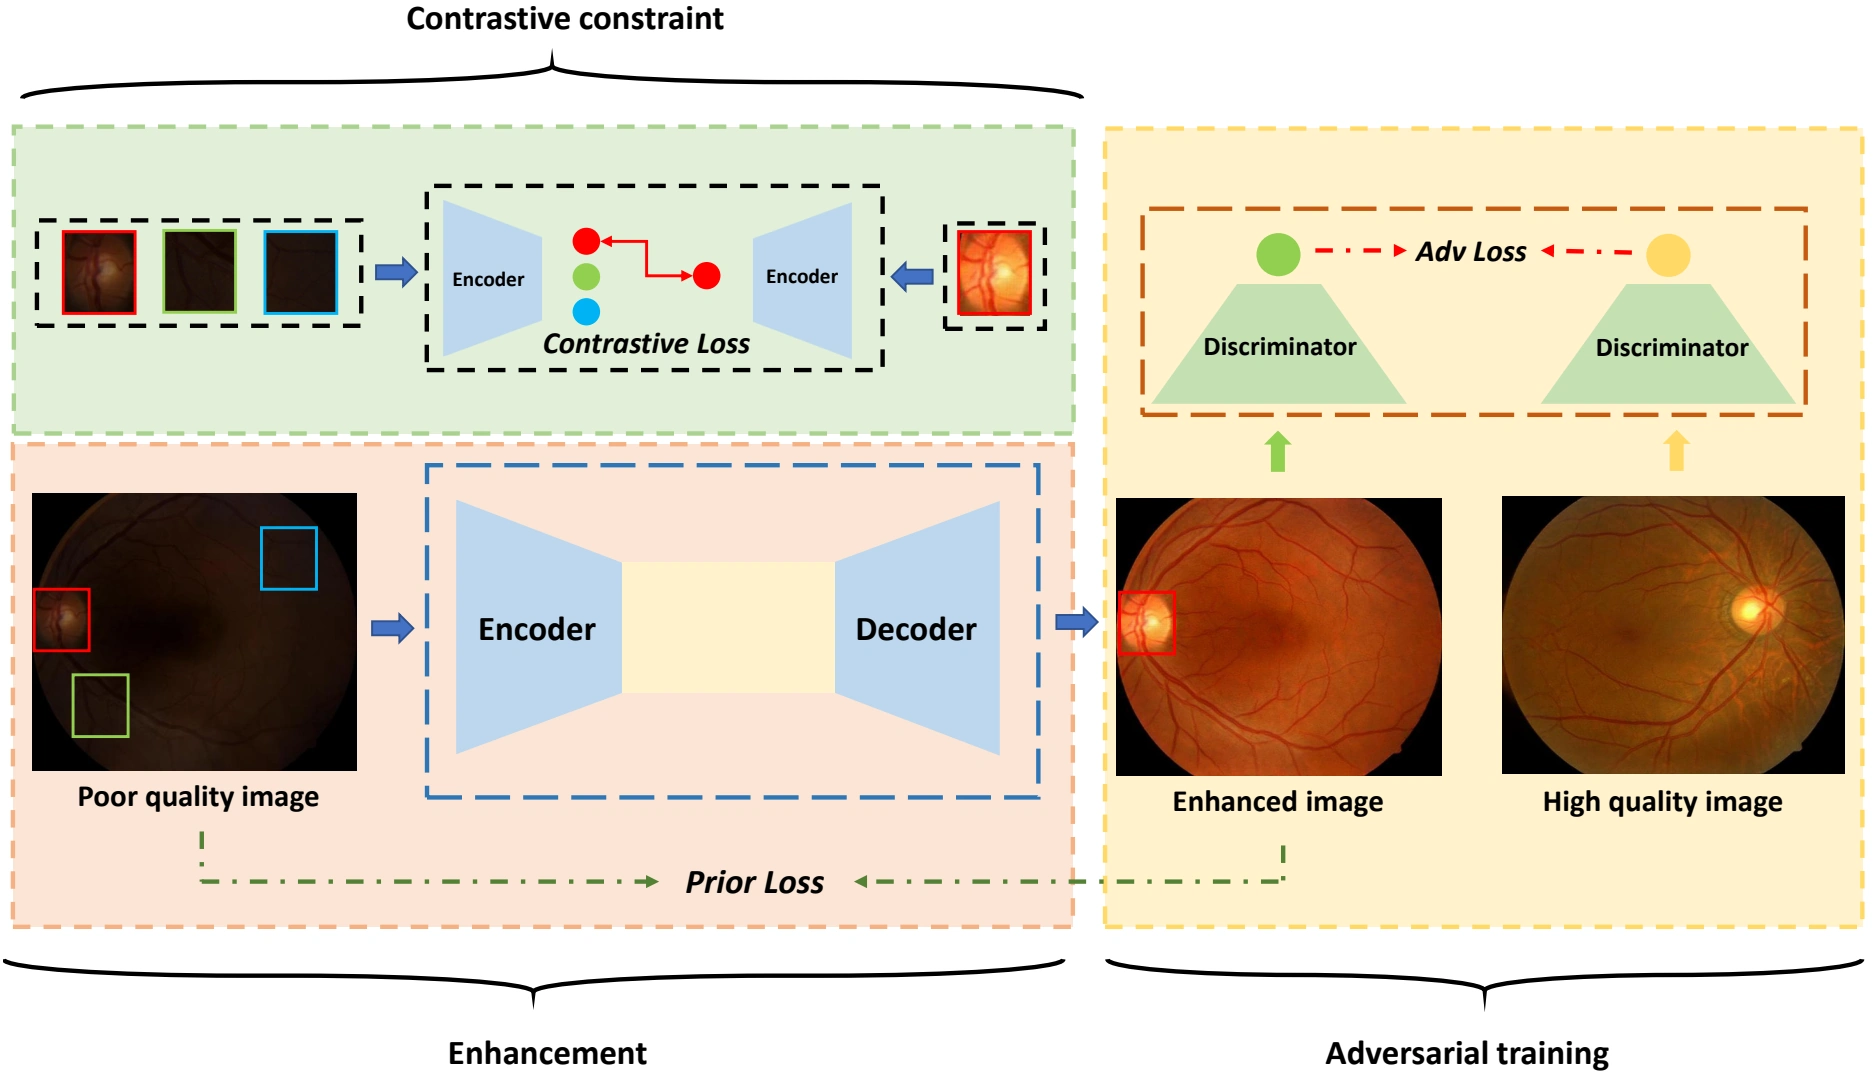
EPC-GAN 通過圖塊級對比式轉換,從未配對的眼底圖像中學習質量增強。眼底結構先驗限制血管、視盤視杯及病灶被改動,同時允許模型校正光照和對比度。
雙向卷積長短期記憶網絡 · 對抗學習 · 視網膜血管分割
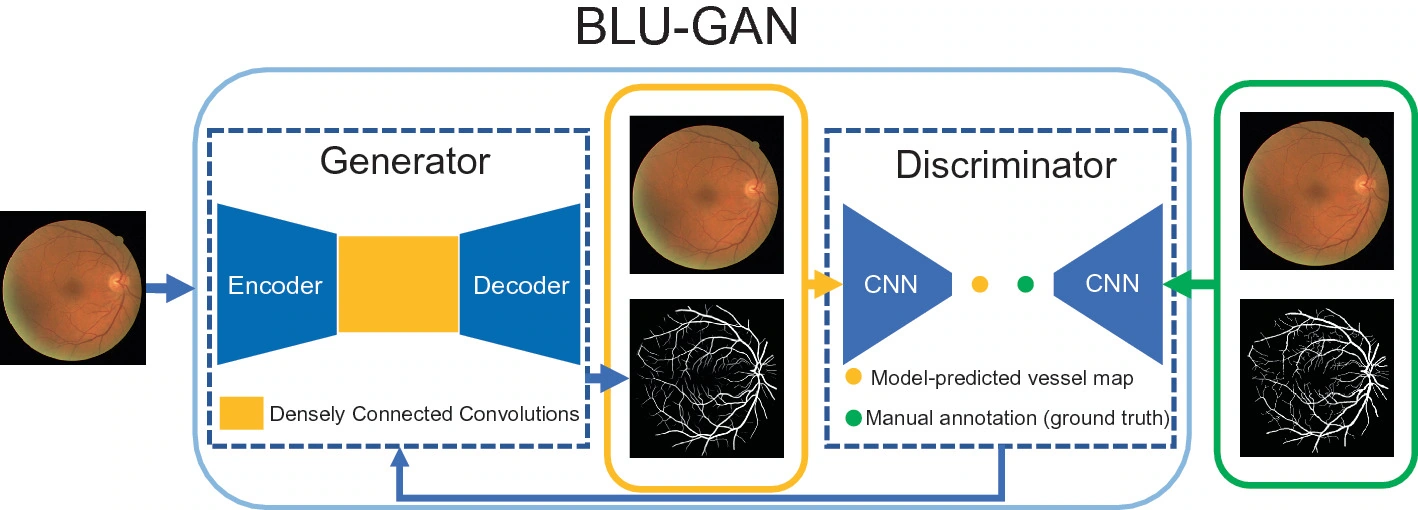
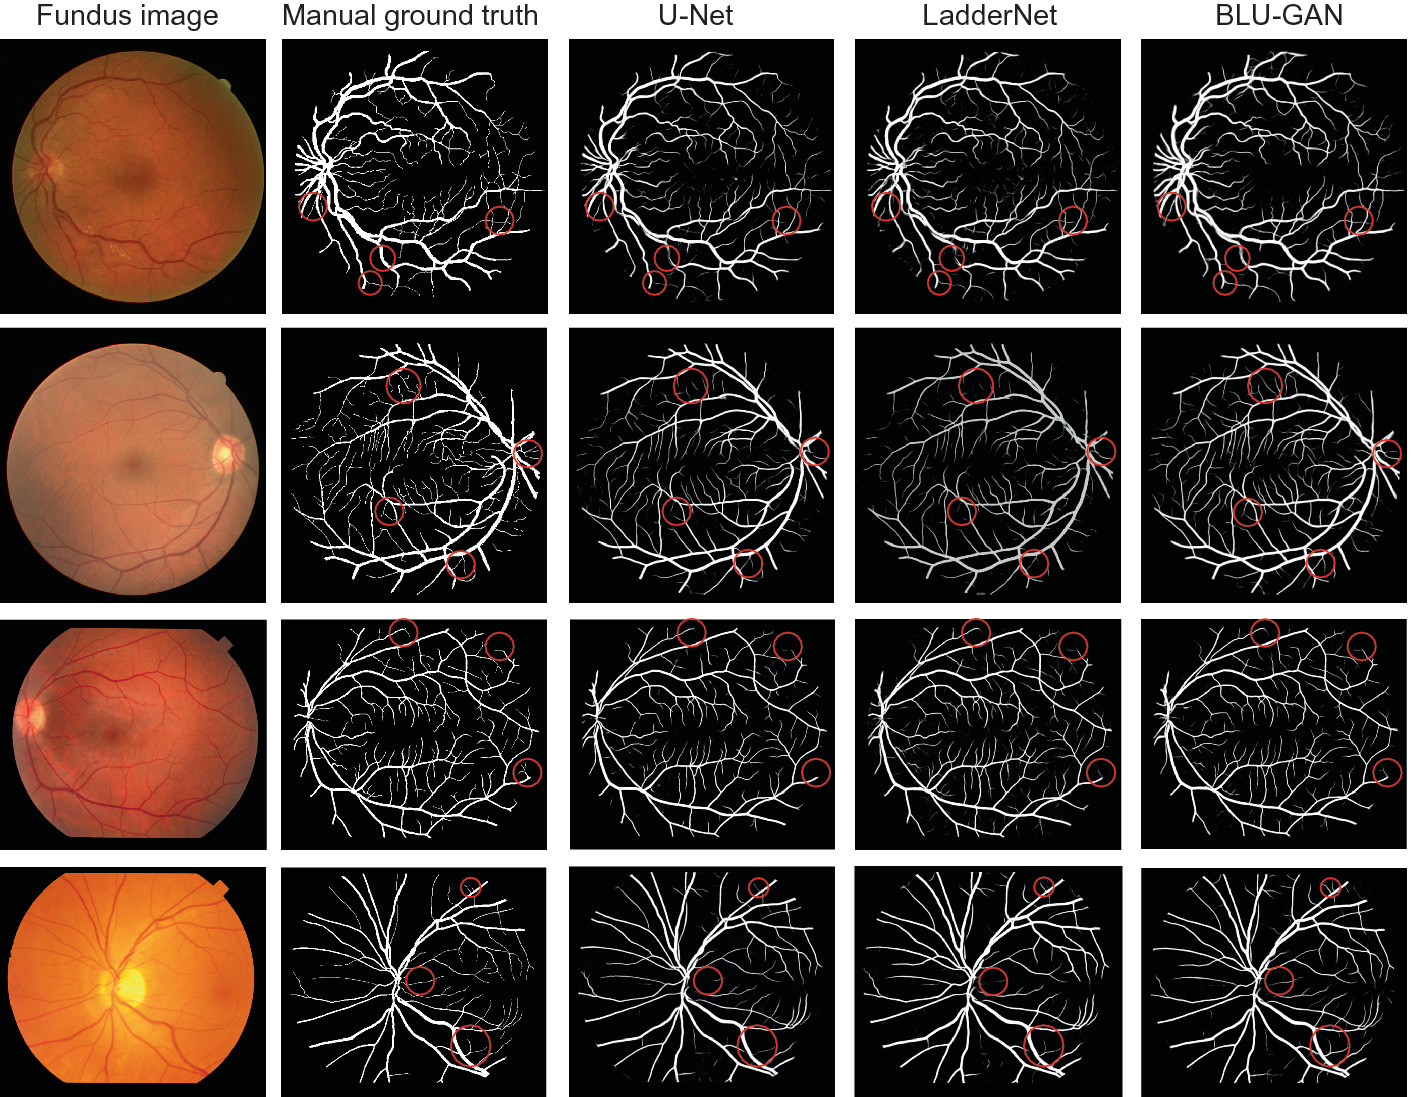
BLU-GAN 用雙向卷積 LSTM 代替 U-Net 的直接跳躍連接,在不同尺度間融合特徵,並結合對抗訓練與密集特徵複用進行眼底血管分割。
病灶圖細化 · 病灶引導特徵融合 · 糖尿病視網膜病變識別
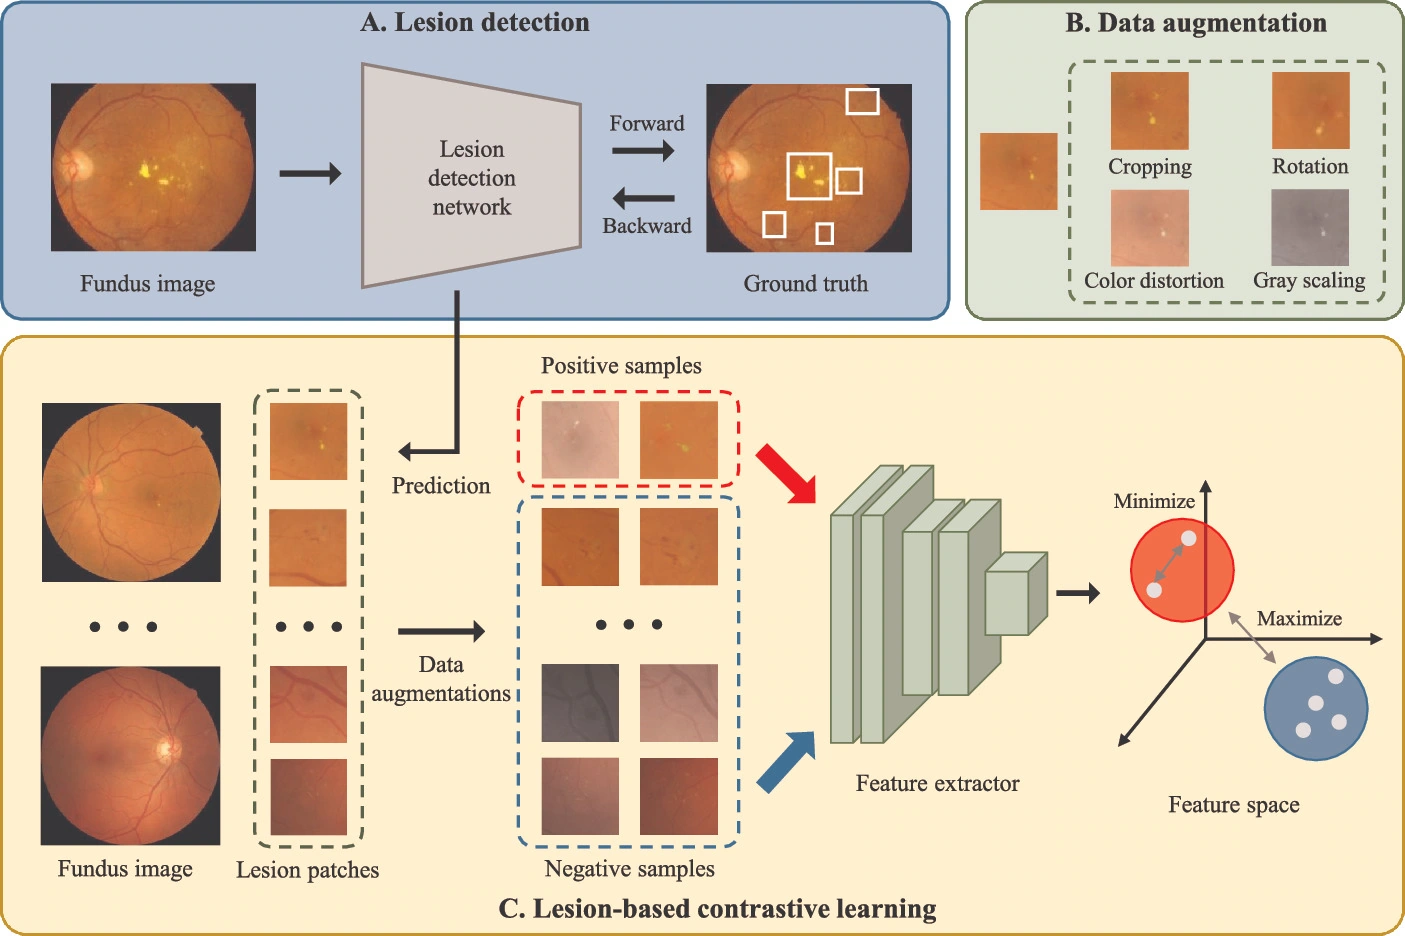
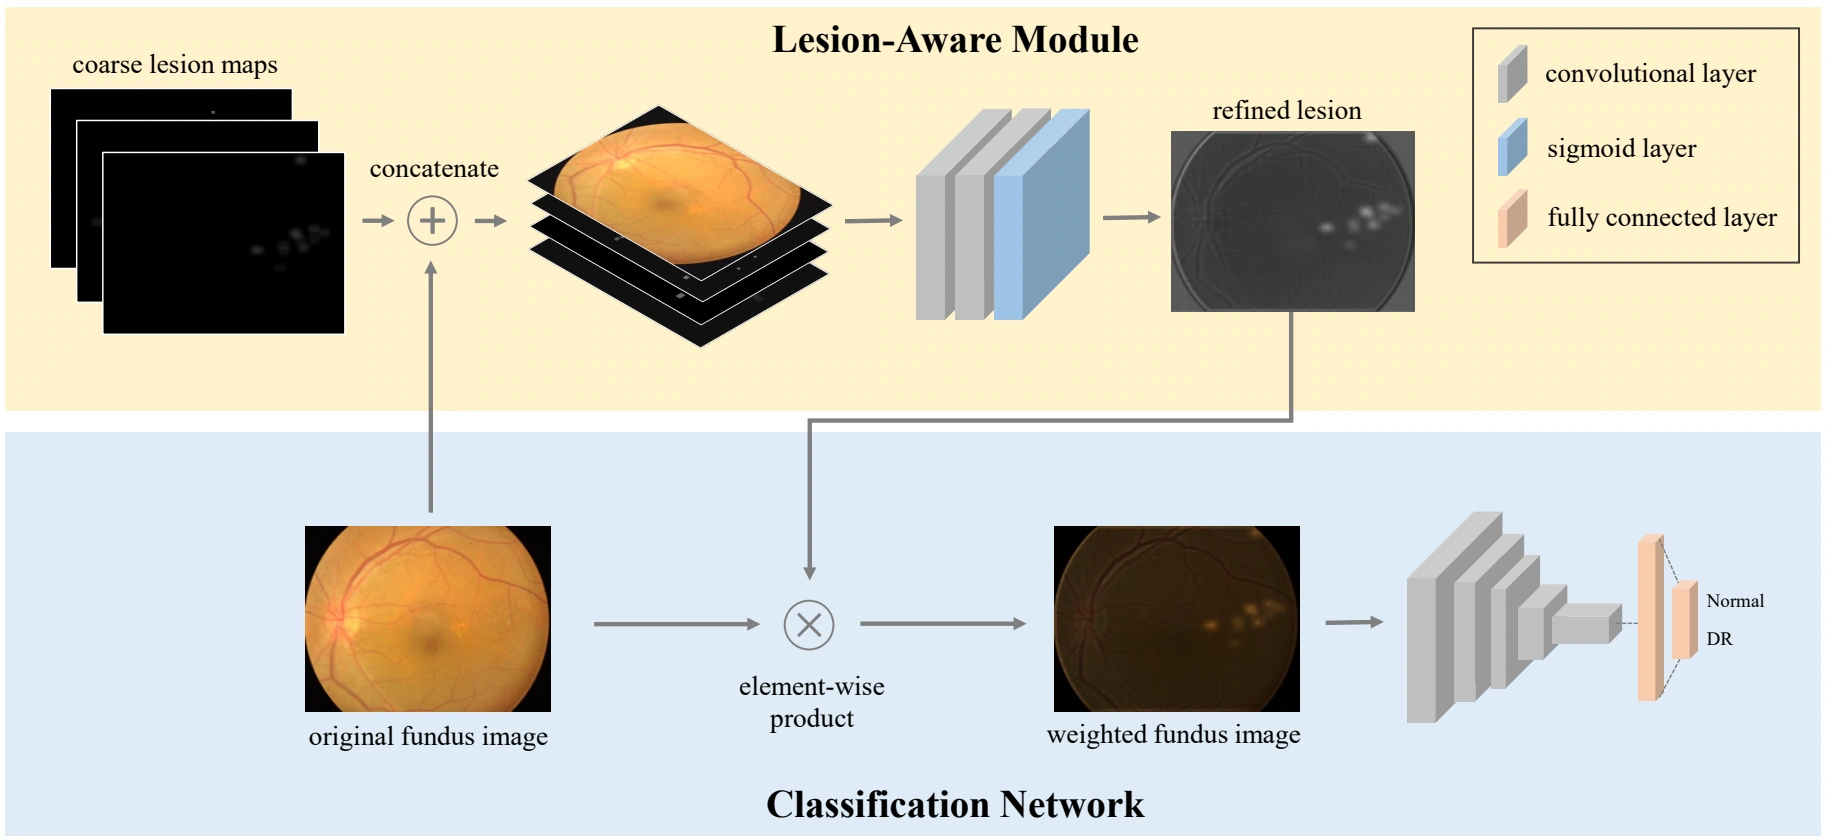
病灶引導網絡先細化由粗標註檢測器產生的病灶圖,再將其與原始眼底照片融合,判別整幅影像是否存在糖尿病視網膜病變。研究以 4,465 張眼底照片構建數據集,對比了使用細化病灶圖、直接使用粗病灶圖和僅使用原圖三種方案。
數據集構建 · 滲出灶檢測 · 多標準視網膜病變分級
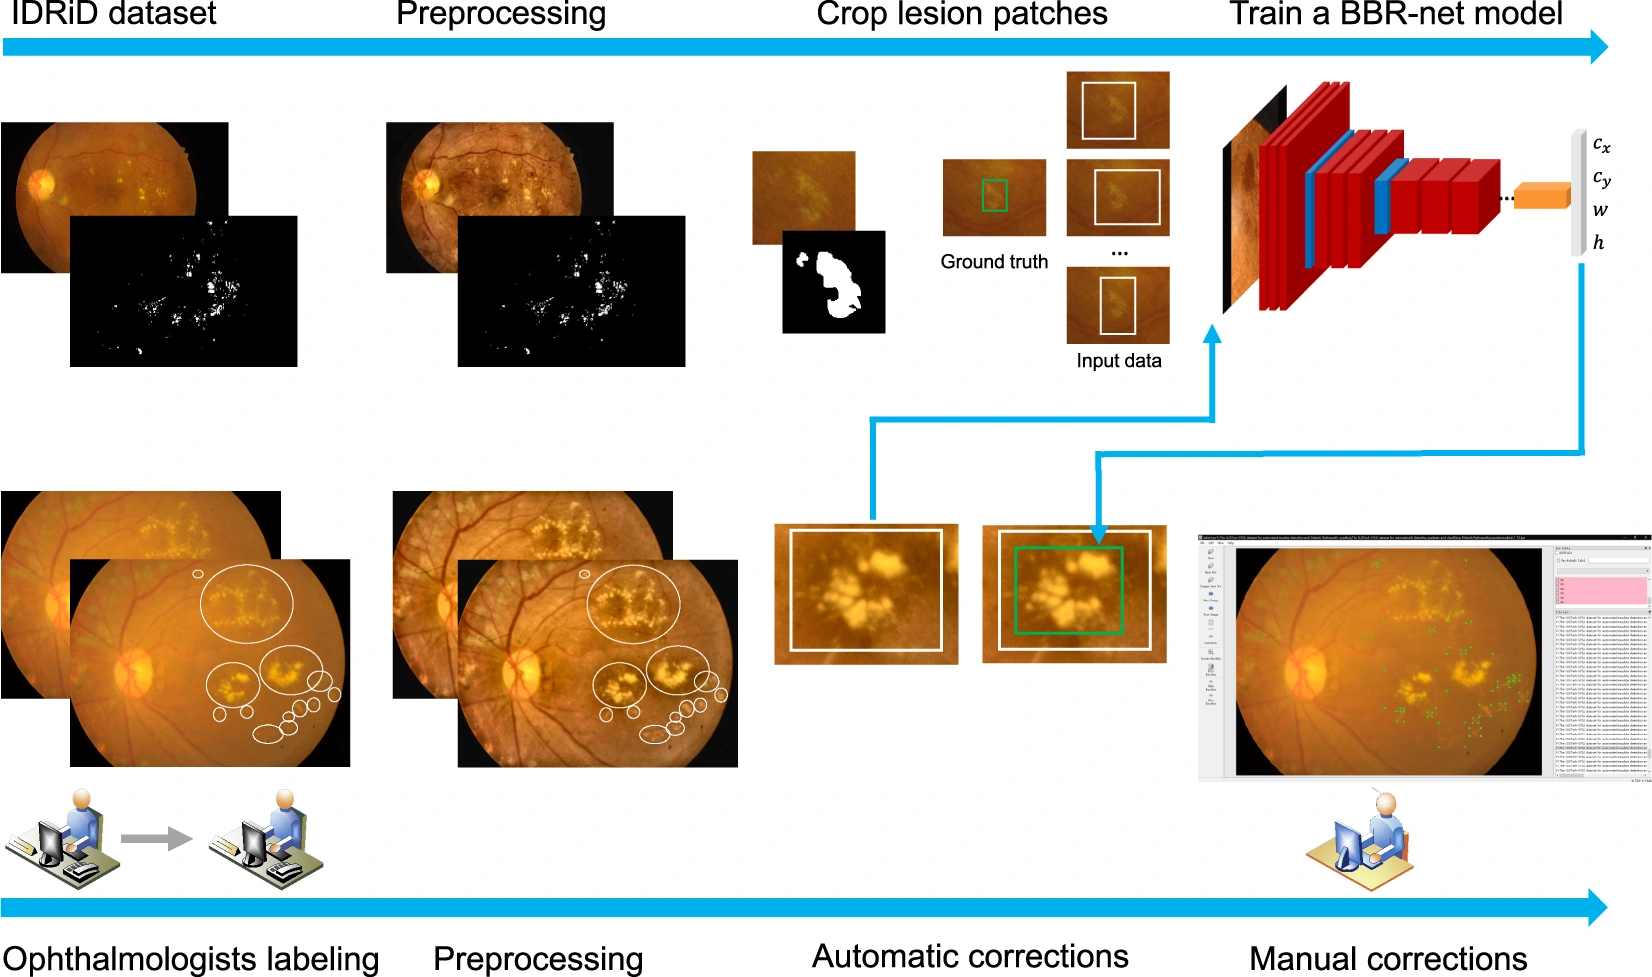
該數據集開放 1,219 張眼底照,提供滲出病灶、視盤與黃斑中心的標註,以及三種協議下的糖尿病視網膜病變等級。數據可用於病灶識別、解剖標誌定位及跨分級協議比較。
弱標註 · 邊界框細化 · 出血灶檢測
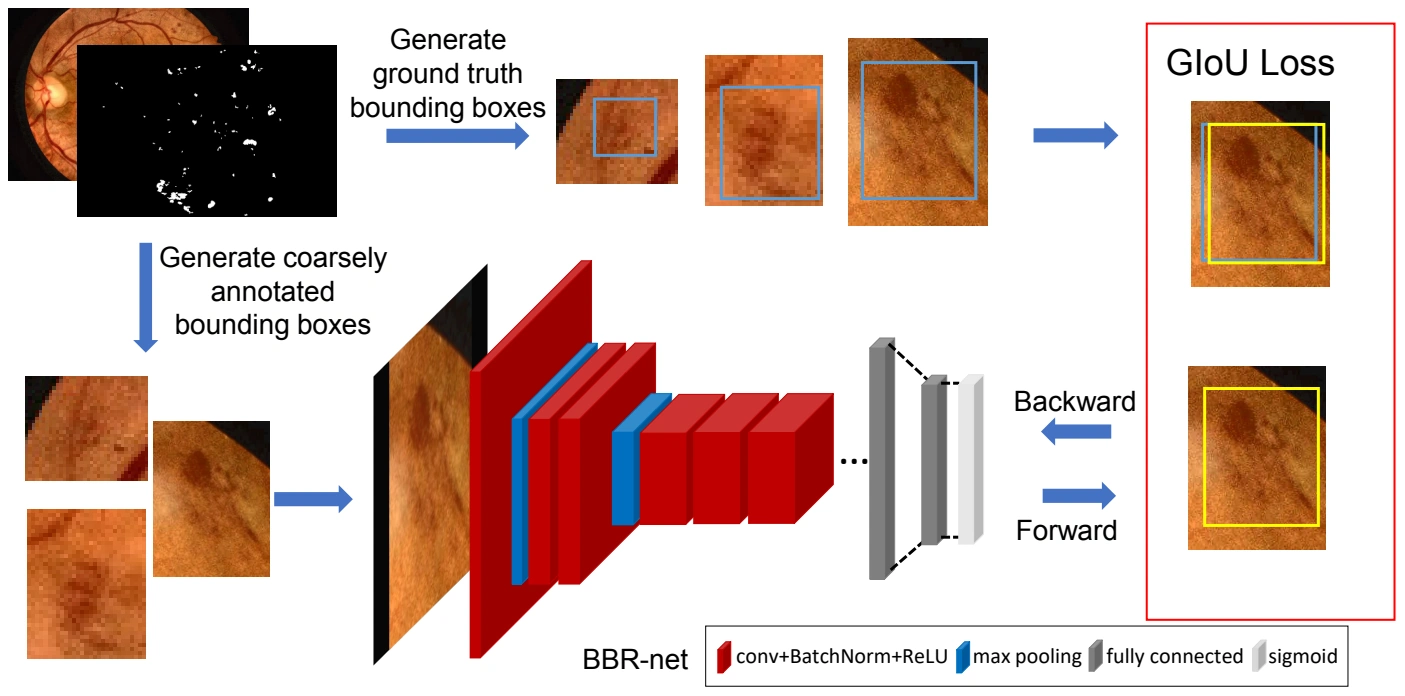
該方法針對眼底出血粗標註中的定位誤差,先用邊界框迴歸網絡細化人工框,再以帶標籤平滑的 RetinaNet 學習出血病灶檢測。
超奈奎斯特信號傳輸 · 循環前綴 · 頻域信道估計
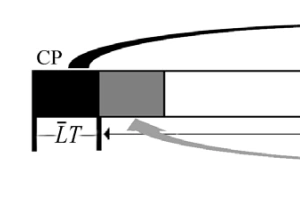
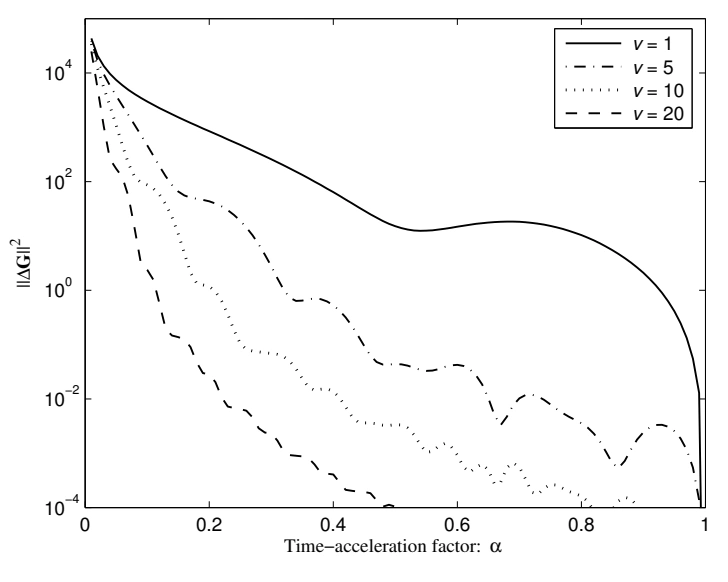
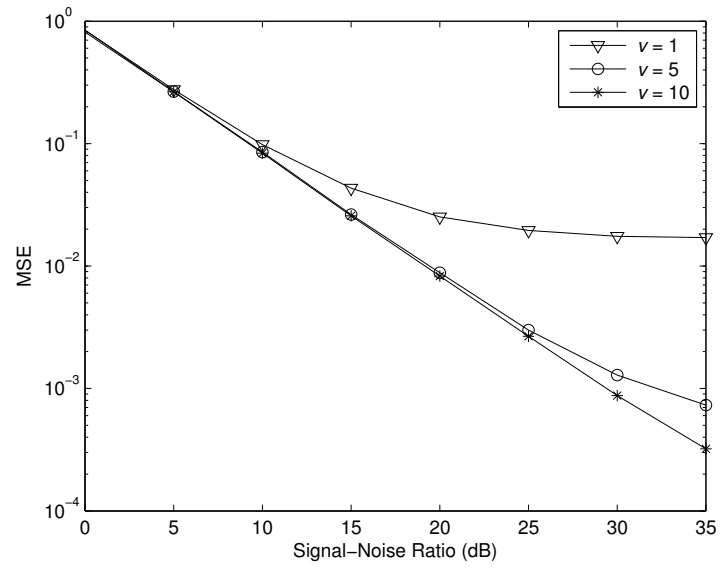
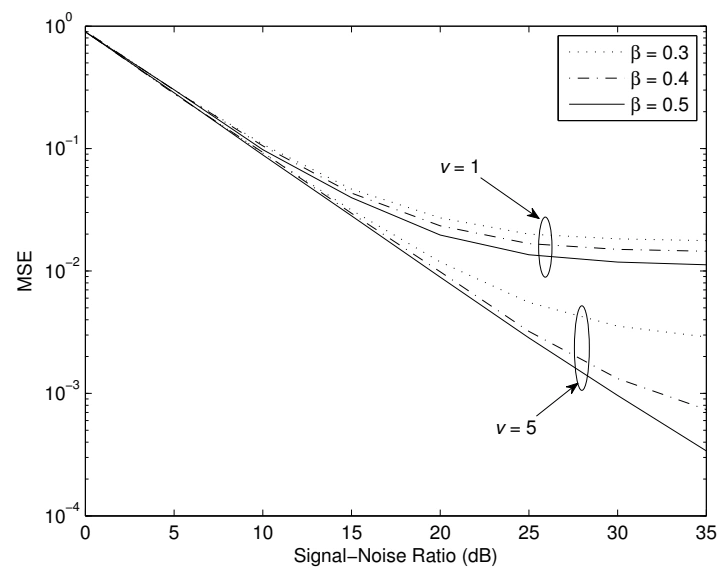
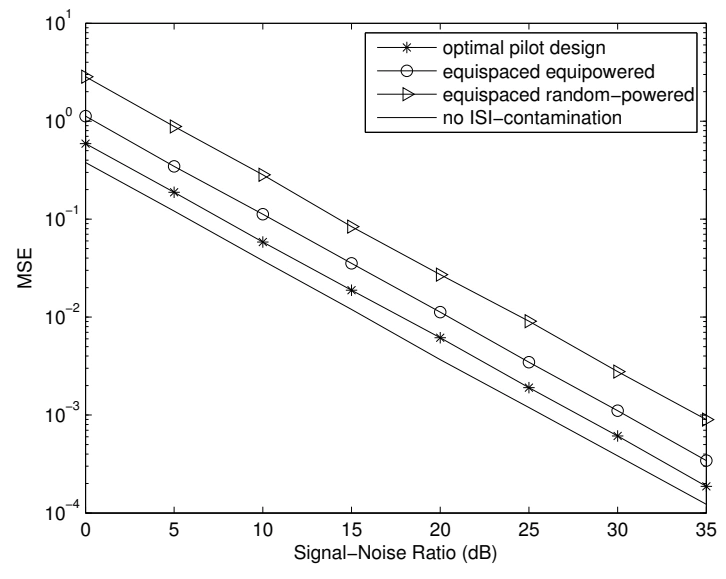
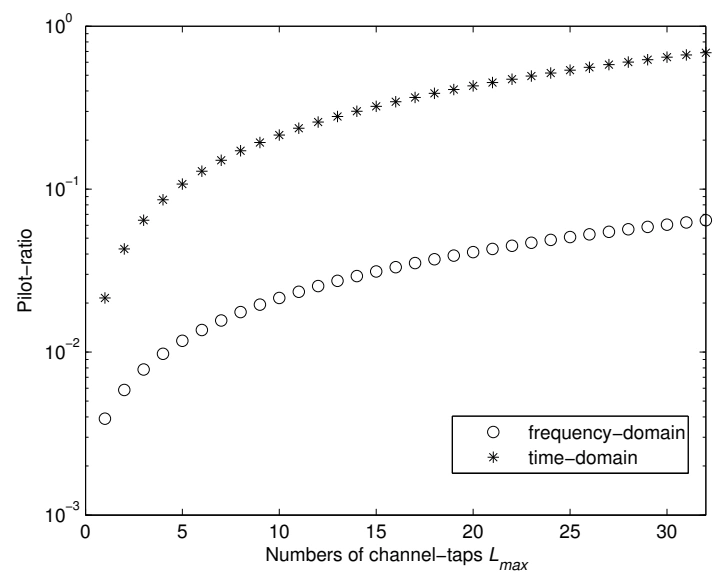
該研究面向碼間干擾記憶較長的超奈奎斯特傳輸設計導頻。額外的循環前綴使干擾可近似為循環矩陣,從而用快速傅里葉變換進行低導頻比例的頻域信道估計。
沒有符合條件的論文。